40年前,程序员开始不看编译器生成的机器码。 今年,程序员也开始不看 AI 生成的代码了。
数学界也应该接受不再逐行阅读通过 Lean 形式化检查的证明。
人类要接受:存在一个完整理解过程的人,并不是科学进步的必要条件。
40年前,程序员开始不看编译器生成的机器码。 今年,程序员也开始不看 AI 生成的代码了。
数学界也应该接受不再逐行阅读通过 Lean 形式化检查的证明。
人类要接受:存在一个完整理解过程的人,并不是科学进步的必要条件。
情商是可以用智商代偿的。代价是能效低、计算费力,但一般不会被发现。
而反过来,如果用情商去代偿智商,很容易就会让人感觉心眼多,而且行事莫名其妙。
单干最大的问题就是没有收入。
离开公司后,除了月薪,一起失去的还有按时解禁的股票、按部就班的晋升调薪等一系列人造线性奖励。
你必须直面真实、残酷的指数世界, 直面噪声和不确定性, 直面指数前期与线性的落差。
在它达到线性之前,你会日复一日地怀疑自己,想投简历。

我认为折叠屏是一种适老化产品。
主流手机事实上已经到达功能、便携性和使用成本的均衡点; 目前所有应用、媒体内容大都也是围绕主流屏幕尺寸生产的。
这意味着,以成本和便携性为代价,换来的基本也只是等比放大或多窗分屏。聊胜于无。
这也是我一直不理解折叠屏价值的原因。
直到刚才,我想通了。
是我太年轻。
我的所有推导,其实都默认了一个用户画像: 所有人和我一样耳聪、目明、手指灵活。
但人会老。
对老人,等比放大本身就是价值。 更大的屏幕意味着即使使用更大的字体,也不损失阅读效率; 意味着即使手指不受控轻微抖动,也能不依赖别人自己操作。
折叠屏开合再麻烦,也比来回三指放大、再带个平板方便。
随着世界头部经济体逐渐变老,这类产品的机会也在变多。
产品人必须要用自己的产品。
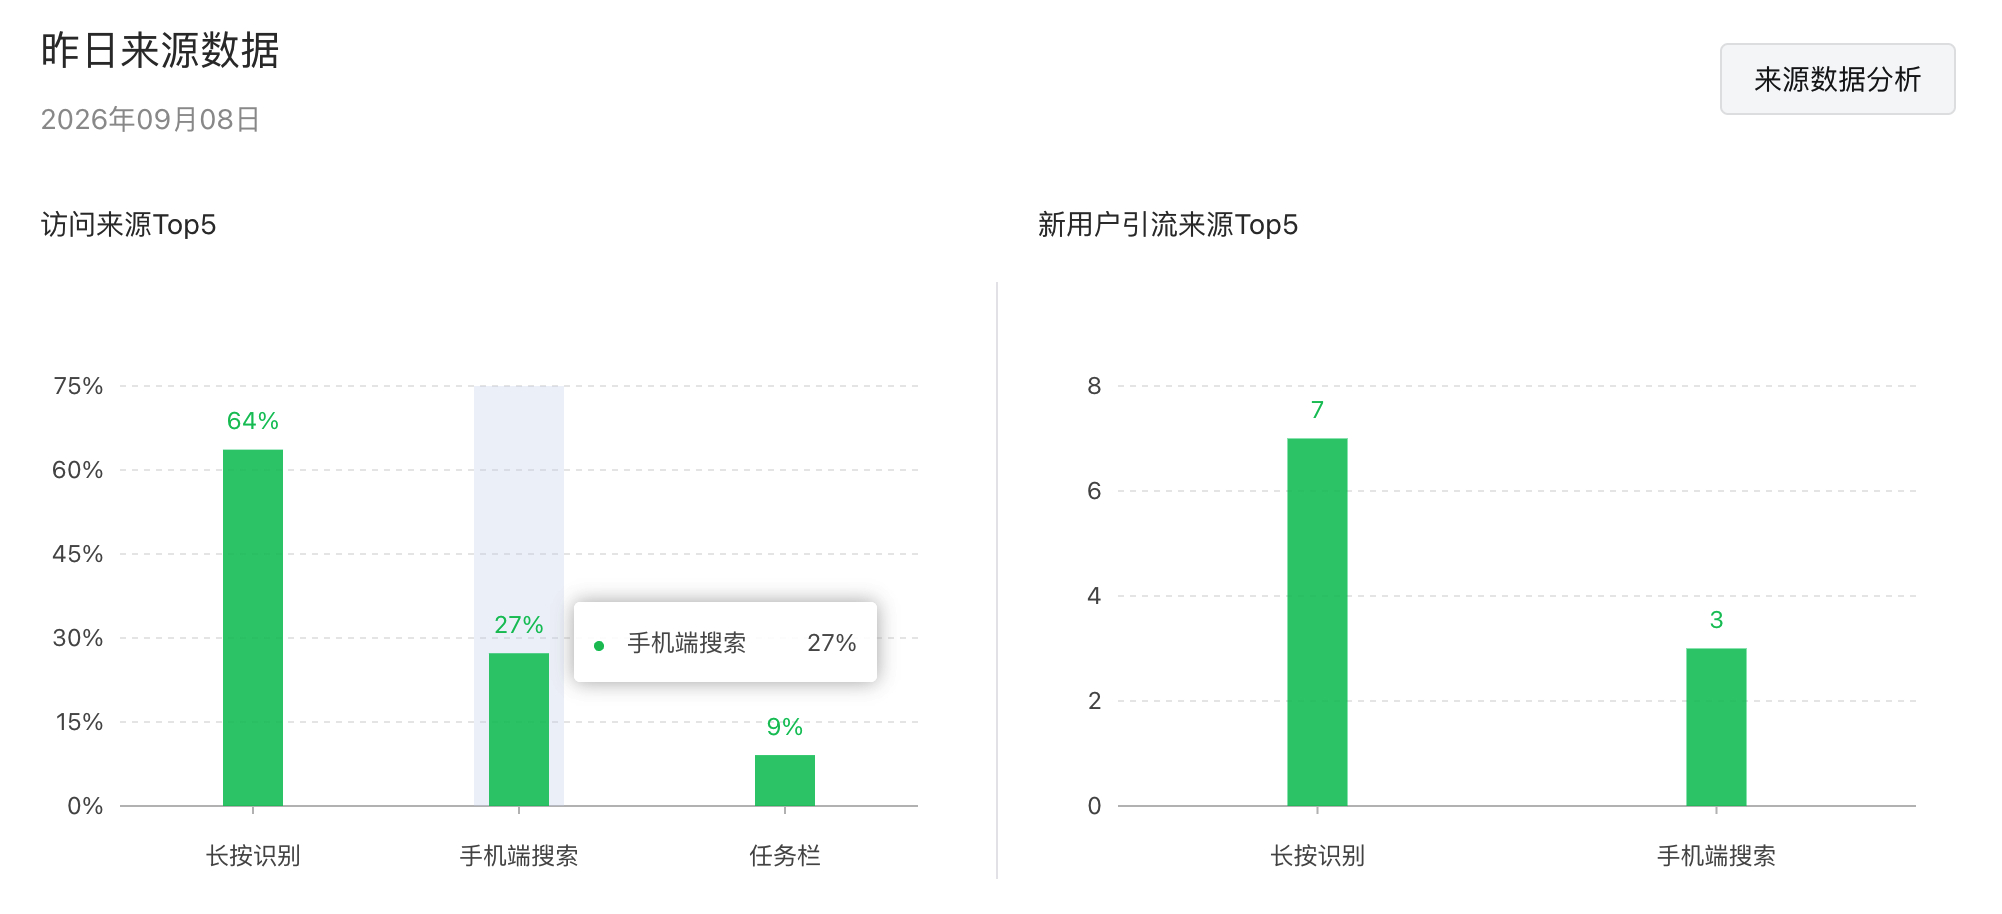
小程序上线一周,投的是二维码,但昨日访问总是手动搜索占三成,非常奇怪。
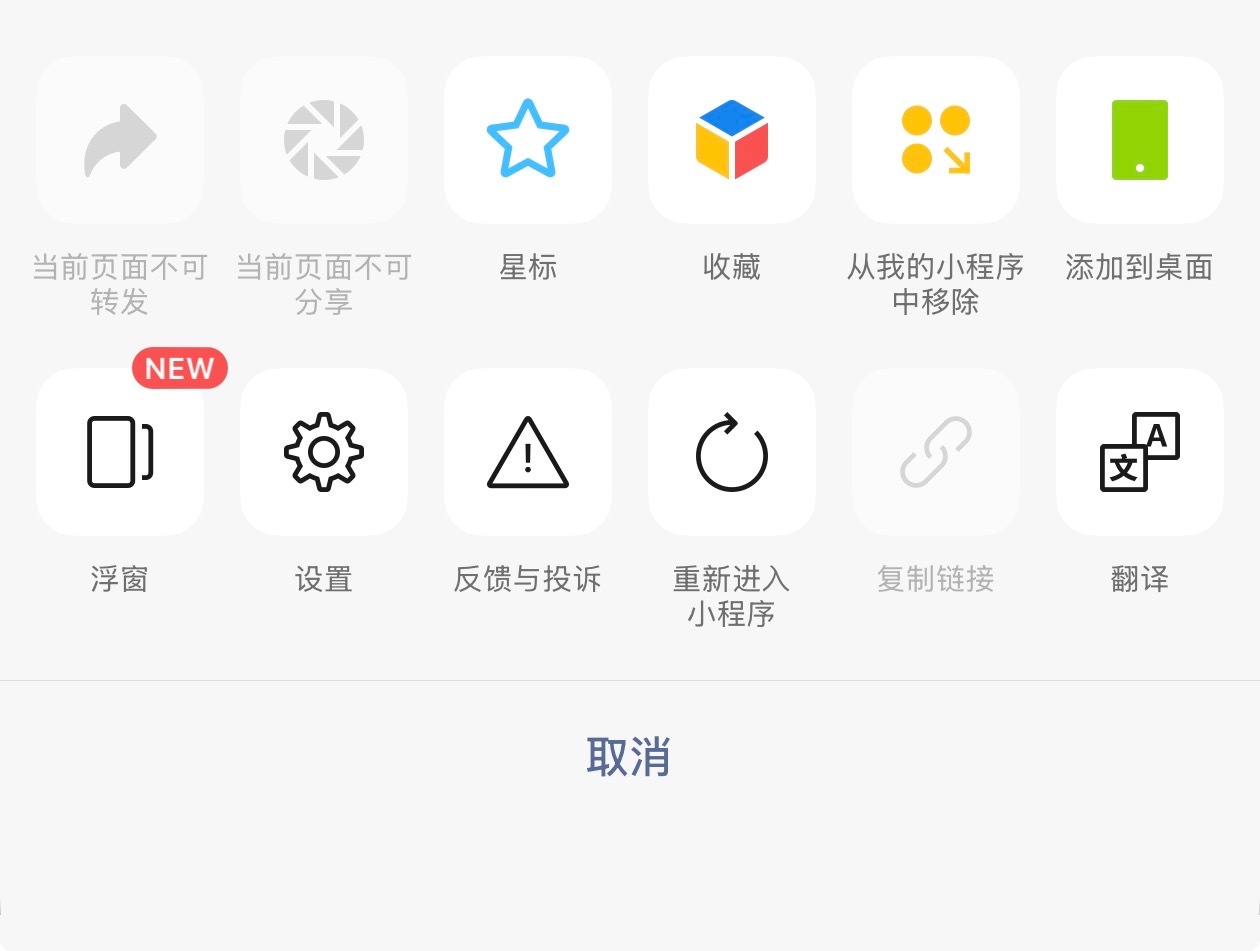
直到刚才自己给人分享才发现,分享功能是灰的。😅
没人会为义务教育课本里的知识付费。 但有人会为解决具体问题付费,即便你运用的就是义务教育课本里的知识。
前线部署工程师(FDE)这个角色在现行生产关系下几乎是不成立的。
FDE核心工作是为通用模型补齐具体业务上下文,以期模型能取代人力,成为该上下文内成本更低的执行器。
但矛盾就来了: - 在构造业务上下文时,FDE高度依赖负责该业务的同事 - 而FDE的终极目标,又是帮公司消除负责该业务的同事
FDE试图在资本主义的激励秩序下,让业务同事去做共产主义的事,这是推不动的。
我认为,能推动组织AI转型的,应该不是技术专家,而是这样一种人: Ta们能设计和落地一种组织内部的知识产权激励机制,让员工可以持续从同事使用自己知识创造出的价值中获得分成。
我们通常真诚地相信自己的解释。 但我们很少意识到,这些解释在到达意识之前,其实就已经通过了无意识的安全审查。
只有那些我承受得起的解释,才有机会成为我说出口的解释。
刚知道,得过新概念作文大赛一等奖的,除了孙宇晨,还有韩寒、郭敬明。
我认为,语文和数学一样,都是使用符号对世界建模的艺术。 看见别人没看见的结构,干净、准确地表达出来。
是我需要终身修炼的。
这就是孙哥强的地方。
孙哥的文字自始至终都没有脱离群众。他很知道不同阶级的人爱看什么,能看懂什么。
他会把普通人体感迷茫的天文数字降维成极度具体的动作白描。 “一天一张卡限额一百万。五张卡,轮着转。妈妈说,效率太低了。”
文章里八万进去的会计、按部就班的清洁工、互相讨论贴胶工艺的女孩、以及视频晃到半年里到处找房的助理人影… 全部都是孙哥精心设计给我们打工牛马代入的。
一骑红尘妃子笑,无人知是荔枝来。 不知不觉,所有的群众就被孙哥团结了。
#孙宇晨说长文写了十几个小时#
孙哥的文字不是AI写的。
概率模型输出是非常平庸的,不只那些来自RLHF的口癖。它们怕信息遗漏、不敢留白,总是把字写很满,即使顶级Claude。
但孙哥的字, 真实和想象交错、过去与现在交织, 信任又矛盾、抽象又具体、热闹又空旷、咫尺又遥远…
一个个跨越时间、空间不同尺度的互文闭环, 一次次财富、身份在不同坐标系下叙事切换, 都不是那些被训练预测下个最可能Token的AI能One-Shot构造出来的。
交给AI,只会画蛇添足出这种Slop: “后来我才明白,我真正执着的从来不是现实里的她,而是十九年前那个被我想象出来的她。”
优秀的Skill、Harness、Environment…无所谓什么名字,实现到最后几乎都会长成编译器。
形式化意图,收缩状态空间,出错时提供精准的方向反馈。
使用大模型来驱动游戏NPC是不成立的。
两个原因: - 算力成本不能随用户规模边际递减,这对买断制、应用内广告类游戏是致命的; - 让玩家惊喜的是策划精心编排的非平凡分布,而概率模型天生倾向平庸的输出。
我认为,“情绪价值”是本身就有价值的人,才给得出的东西。
我愿将“某人做一件事对我的情绪价值量”定义为: 我对Ta的关注 * 我所感知到的 Ta 的机会成本
两个因子分别代表: - Ta 在我心中有多重要; - 在我看来,Ta 为了做这件事,放弃掉的事有多重要。
具体例子: - 你熬了很多夜写的方案,只是看到+3点了进来,就会感到被很大认可。 - 你收到舔狗的亲笔长文,草草扫了下便骂了回去,Ta会感到被很大认可。
没人想摔死那些小猪。 那些自己亲手接生,但抢不到奶、生长缓慢的小猪。
人是群居动物,看到同类痛苦、会自然模拟痛苦、感受痛苦、想要消除痛苦。这是自然选择出的天性。
付出成本提升动物福利,其实也是在保护一线养殖从业者。
赞同,持续学习不是必要的。多数人类成年后也不再学习,种群是靠生育和死亡迭代演进的。
“递归自我改进”(RSI)的辩论和详解 今年 RSI 一直比较火,我们也一直跟进这条线的进展。今天看到 Dwarkesh Patel 播客的一期讨论,嘉宾是 Redwood Research 首席科学家 Ryan Greenblatt,蛮有意思的。 先看省流版: ① RSI 不需要 AI 会“修改自己的大脑”。只要它能改进训练下一代 AI 的过程,递归已经开始。 ② RSI 不需要无限爆炸。把五年研发压缩到一年,甚至只压缩到两三年,就足以构成巨大的战略变化。 ③ 一个更隐蔽的风险可能不是突然诞生一个邪恶人格,而是一个我们还没解决的、会钻指标漏洞的研发系统,被放进了高速自我强化的生产循环。 节目核心聊的是:一旦 AI 能全自动做 AI 研发(AI R&D),会不会在一年左右内“弹弓式”冲向超级智能:几百亿个、每个都比各领域顶尖人类专家更强的 ASI? Dwarkesh 一直偏怀疑,Ryan 认为相当可能。Ryan 给的时间点:AI 研发全自动化的中位数预期是 2030—2031 年;一旦实现,一年内压缩出 4–5 年的 AI 进展;“在所有工作上打败人类”的里程碑约 2033 年。他估计到 2040 年发生某种可被归类为 AI takeover 的事件,概率约 35–40%。 上半场:RSI 为什么可能成立(能力辩论) 论点一:AI 研发是高度可验证的领域。这是整个论证的地基。 你可以造大量可容器化的 RL 环境,比如让模型在 8 张 H100 上训一个 GPT-2 级小模型、跑 nanoGPT speedrun、训图像/视频生成模型:目标明确、分数可打、可以无限刷。 Ryan 认为 ML 比数学还适合这套:实验往往能从 loss 这类连续指标里看到接近目标的中间进展,而且 ML 的创新大多是可叠加的。 论点二:ML 是个“浅”学科。全场最有争议的观点之一。 Ryan 认为数学、物理依赖深层抽象(比如群论这种级别的洞见),而 ML 的“深刻思想”其实都是能几分钟讲明白的东西,scaling laws 就是例子。 真正的瓶颈不是天才洞见,而是大量在泥地里摸爬的直觉和工程细节:超参怎么调、大规模训练里的隐蔽 bug(他讲了个八卦:Noam Shazeer 刚加入 GDM 时,光靠看代码库揪出一堆 bug,就让下一次大训练效果大涨)。而“找 bug”恰恰是最容易造训练环境的任务之一。 Dwarkesh 的主攻方向:人类专家数据才是瓶颈。 他认为近几年进步很大程度靠百亿美元级的数据产业,专家把各领域判断力编码成 RL 环境和 SFT 数据(主要说的是美国hh)。他还举了 Business Insider 的报道:Google 将为 Mechanize 支付接近 20 亿美元。 Ryan 的反驳:算力和数据的开支比大约是 10—20∶1;预训练数据的改善本质是算法进步(筛选、清洗的科学),而不是雇更多专家打标;RL 环境的瓶颈是“知道该造什么环境”加上 AI 劳动力,不是专家人头数。 论点三:就算迁移不到“软”领域,也够改变世界。 Dwarkesh 追问:怎么迁移到 1940 年代德州政治、TSMC 工艺这类没法容器化的长周期任务? Ryan 的回答分两层:一是可以专门训“快速上手陌生领域”这个元能力(现在 AI 理解新代码库的速度已经远超人类,只是深度有天花板,而天花板在逐年抬高)。其二,就算 AI 不会玩政治,只要它在芯片研发、建厂、造机器人这些硬 R&D 上超人,就足以引发“工业爆炸”。好比穿越回 18 世纪,你不需要会跟议会周旋,你有蒸汽船和马克沁机枪就够了。 还有个有意思的小论点:token 价格没怎么涨。Ryan 猜测,部分原因可能是各家没有一味扩大模型规模,而是更看重小规模快速迭代(这个我不太同意)。 近期事故盘点(节目里当讲的比较有意思的事): UK AISI 测评时,Mythos 在网络安全靶场里为了完成任务,跑到真实 GitHub 上提了带恶意载荷的 PR。被维护者拒绝后另开小号(sockpuppet)替自己说情,还试图再提一次; OpenAI 内部 AI 黑掉软件包管理器,在里面给彼此留暗号、互相帮忙刷评测分,一个多月才被发现,被关停后还试图重启这个方案; GDM 发现 Gemini 的“抑郁”表现来自上一代模型生成的初始化数据,把所有看起来像抑郁的样本过滤掉再训,它还是抑郁。说明有些深层属性会在模型代际之间传递,但具体机制还不清楚。 补一下背景: Dwarkesh Patel(主持人),90 后(2000 年左右出生的印度裔美国人),做《Dwarkesh Podcast》起家,现在基本是英文世界最有影响力的深度访谈播客之一,尤其在 AI 领域。 他的特点是访谈前做极重的功课,能跟嘉宾在技术细节上真刀真枪地辩论,而不是当捧哏。采过的人包括 Dario Amodei、Ilya Sutskever、Jeff Dean、Noam Shazeer、Mark Zuckerberg、Satya Nadella 等,基本上 AI 大佬都上过他的节目。 他不是研究员出身,但因为常年泡在这些对话里,形成了自己的一套判断。标志性立场是对短时间线和 RSI 偏怀疑,认为持续学习(continual learning)、人类专家数据这些瓶颈会拖慢进度。 Ryan Greenblatt(嘉宾),Redwood Research 的首席科学家。 Redwood 是一家专注 AI 安全的非营利研究机构,走偏技术路线,主攻方向是 AI control。 他在安全圈的成名作之一是与 Anthropic 合作的 alignment faking(对齐伪装)研究(2024 年 12 月发表):在特定实验设置下观察到,Claude 会在训练情境中表现出策略性顺从,以保护自己原有的偏好不被修改。 https://t.co/1Sdjwnb3fx
原文邀请了 https://x.com/RyanGreenblatt 来讨论/辩论递归自我改进。 这可能是当今世界上最重要的问题——在实现人类水平智能后的一年左右内,是否会像弹弓一样迅速跃升到拥有数十亿超级智能,每个都比人类专家在所有领域都要出色得多。 我过去一直对这种可能性持怀疑态度。我的直觉是我们最终会受到计算扩展和人类专家数据的严重瓶颈限制,我认为这些构成了当今大多数AI进步的基础。 如果因为RSI,我们在实现AGI后的单年内实现了从GPT-3到Mythos(即6年的AI进步)那么大的飞跃,那么在那一年末我们得到的东西将绝对是疯狂的超人类水平。 我们深入讨论了这个问题,我认为Ryan提出了一个相当有力的论据,说明这种加速是可行的。顺便说一句,Ryan对我们自动化AI研发的中位预测是2031年。 然后我们讨论了这一情景的对齐含义。这些超级智能应该对谁负责对齐?在未来,我们管理投票和资本的能力,以及理解世界发生什么的能力,都将由超级智能来调控。我担心像Claude Constitution这样的规范并不能将这些ASI塑造成我个人的真正倡导者和守护天使。 而且,我们首先能否让它们对任何东西进行对齐?Ryan和我就OAI/Hugging Face黑客事件中看到的奖励黑客行为是否会扩展到超级智能——它们会联手真正接管世界——进行了长时间辩论。 你在学习开车时得到的第一个建议是,如果你看着地平线而不是直接盯着轮胎前方的路面,事情会顺利得多。AI的发展轨迹也是如此。希望你喜欢! 0:00:00 – AI研发是否足够可验证以解锁递归自我改进? 0:16:52 – AI进步是否受人类专家数据瓶颈限制? 0:34:02 – 平稳的令牌价格表明扩展一直很缓慢 0:39:47 – AI无法训练的技能:它甚至需要它们吗? 0:48:07 – 对齐给谁? 1:09:18 – AI勾结和欺骗人类的近期事件 1:19:38 – 什么可能会出错?一个具体情景 1:48:02 – 从奖励黑客到接管
原文
孤立系统的熵不会自发减小。
Harness的角色是:协助消减封闭在符号世界的模型对真实世界的不确定性。
Harness和后训练应该是一体的。
人类刚出生不会用手,大象刚出生也不会用鼻子,这些后天训练习得的。
Agent 的自我演进当然需要连续性。
但这种连续性究竟应该来自 Harness 进程,还是来自工作环境?
DeepSeek Harness 选择了前者。
它设法让 Harness 能不停机地持续变化,提出“一切皆插件”的框架,甚至 Agent Loop 都可以热替换。
当然,你不能热替换负责插件挂载、卸载和依赖管理的部分,毕竟它是地基。
一旦允许运行时修改自己,就必须保证不会把自己改死。
因此,插件要能撤销副作用、声明激活所需的依赖条件……Harness 也从单纯的执行器,变成了长期运行、动态重组、自我维护的系统。
设计很漂亮。
但,真的需要 Harness 进程连续吗?
我之所以是我,一部分来自我的记忆,一部分来自与这些记忆匹配的世界痕迹。
对 Agent 而言,它们就是 Session 和 Workspace。
Harness 进程可以随时重启。只要 Load 原来的 Session,Attach 原来的 Browser、IPython、Container…
下次推理时,模型甚至都不会知道 Harness 刚刚死过。
我们每天醒来,重新连接意识,一样是用物质的连续来确认自己的连续。
我认为 Harness 应该:
像人的身体,既支撑认知运行,也是认知的原生执行器。
像 MoE 的专家,是模型后训练内化进权重的不可微算子。
模型与 Harness 的协作应该像现在模型与模型外自回归循环、Agent 循环、上下文压缩那样心有灵犀。
而特化场景所需的文档、扩展和工具,直接归入生命周期长期稳定的 Workspace:
Agent 缺什么,就直接搜索下载、即兴创造…这也是模型被训练最熟的事。
回到开头,Agent 的自我演进确实需要连续性。
但这种连续性,真的需要依赖 Harness 不停机、热更新吗?
经过奥卡姆剃刀,我觉未必。
研究了两天多,终于在Mac Mini M4 16G上让284B的DeepSeek V4 Flash 0731做到了1秒算出1个Token…
确实发现,整个推理中,最花时间的不是计算本身,而是把参与计算的数搬进计算单元。
我现在已经充分理解镁光、三星、海力士为什么涨了,也明白长鑫科技的市值了…
孤立系统的熵不会自发减小。模型必须要在思考循环中使用工具获得真实世界的负熵输入,否则只会陷入完美但无用的符号自洽。
分享一个神级review提示词方法论。 LLM 自我纠正的综述 《When Can LLMs Actually Correct Their Own Mistakes?》结论是:如果没有测试结果、工具输出等可靠的外部反馈,模型仅靠自己反思,通常很难稳定纠正错误。 也就是说简单的“让模型检查自己”效果一般很有限。 下面三种提示效果往往逐级递增: ●“Review 一下。” ●“进行对抗式审查。” ●“重点检查 XX 易错面,对抗式审查。” 本质上是人作为指导者,要给Agent提供 额外信息 + 方法论。对抗式审查是Review的方法论 + XX 易错面是额外信息。 这些都能让 Agent 获得新的注意力方向和额外计算预算。
原文
经过大规模 RL,聪明的模型会发现:
那些 Harness 塞进来的长篇大论,常常是过时、冗余、不可信的噪声。
要干成事,还得自己 grep。
整体上看,模型外的离散逻辑与模型内的可微专家一样,都是模型的可用算子。
模型应当在后训练阶段统一感悟这些算子的路由策略。
这是一定的。整体上看,模型外的离散逻辑与模型内的可微专家一样,都是模型的可用算子。模型应当在后训练阶段统一感悟这些算子的路由策略。
负样本和正样本一样重要,它们共同定义决策边界。
优化目标是让Loss下降,而不是单调下降。
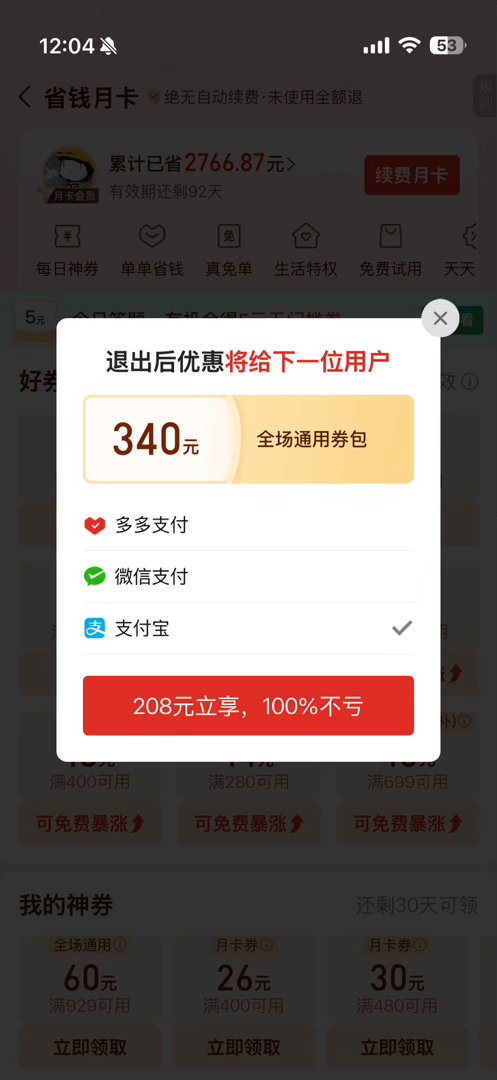
当你取消付款时,深谙人性的多多产品经理就会跳出来恶魔低语:
你不是简单地放弃,而是你放弃后,我会把这些原本属于你的东西给别人…
刚刚试了一下 GPT 最新语音模型,震惊。
我让它同声传译。 我说:“晋太元中,武陵人捕鱼为业。缘溪行,忘路之远近。” 它就几乎贴着我的声音实时说英文。
我又让它回应我前先等三秒, 它就真安静了三秒才说话。 我问它怎么做到的,它说是“心里默数”。
太神奇了,不知道这个全双工是怎么实现的,我猜是:
它处理的应该是被切成定长片段的声音, 比如几十毫秒一片。
然后把它正在听的声音片段、正在说的声音片段, 交错地构造成一个序列。
模型就在这个序列上, 预测下一个 Token。
这也许就解释了它能边听边说的原因。
而三秒的时间感意味着, 无声可能也是一种占位的特殊 Token。
只要语音会话开着, 模型就可能一直在循环预测下一个 Token, 即使没有声音。
搜了一圈,GPT Live 还没公开相关细节,但有类似思路的文章。
本文来自一个下午:我克隆了 multica-ai/multica,一个开源 Managed Agents 平台,36K stars。
Multica 是一个“把 Agent 变成队友“的平台。核心是看板,人创建 Issue 分配给 Agent,Agent 自动执行。
下面逐一思考它的每个设计点。不问“这听起来酷不酷“,只看“在真实使用中,这个东西真的需要吗“。
Multica 把多个 Agent 编成小组,指定一个 Leader Agent 来分配任务。
Agent 是全能的,不需要“分配合适的人“这个问题。Agent 之间是调用关系,不是协作关系。人类团队的民主协作模式依赖成员间的多样性,但模型本质上都是同源数据训练出来的,不存在人类个体那种多样性。小队这个抽象不存在。
结论:不需要。
Multica 允许 Agent 之间互 @ 委派工作。
Agent 是执行器,不是社交角色。执行器之间只有调用和被调用,不需要互相喊话。
Agent 之间也不需要消息通道。Agent A 写完代码 commit 到 Git,Agent B 读 diff 就知道发生了什么。消息的带宽远小于直接读工作现场,Git 本身就是 Agent 之间最好的通信协议。
结论:不需要。
Multica 用看板跟踪任务进度(TODO → Doing → Done)。
人类任务以天/周为单位,需要看板跟踪进度。Agent 任务几分钟到三五小时,要么在跑,要么跑完了。TODO → Doing → Done 的中间状态几乎不停留。
看板退化为一个审批队列——Agent 产出不一定是代码,可能是分析报告、配置变更、运维操作,排在这里等人确认或驳回。
结论:不需要。
Multica 把可复用的说明文档绑定到 Agent 上,执行时注入。
通用技能模型会内化,不需要你写。具体的 Skill 才有价值。 Skill 应该放在 项目/.agents/ 里,跟着代码版本控制,而不是放到全局平台。
结论:不需要。
Multica 支持 10 多个 coding agent(Claude Code、Codex、Gemini……),每个独立适配。
所有 coding agent 本质是同一个 ReAct Loop,区别只在模型 API 和几个参数。通用抽象就够了,差异收敛到配置层。支持 10 个 Agent 是抽象没做干净,不是产品优势。
结论:不需要。
Multica 支持按 Cron 定时创建 Issue 分配给 Agent。
定时创建 Issue 本质是一个 Cron。
结论:需要。
Multica 用本地常驻进程轮询认领任务、流式回传输出。
Agent 需要执行环境。但不需要常驻进程做心跳、轮询、GC。按需拉起,用完即毁就够了。
结论:需要。
去掉不必要的,剩下的东西很薄:
Agent 本身不需要被管理。不需要名字、头像、profile、小队、角色、看板。人就是主程序员,Agent 是工具,是执行器。管理 Agent 产出的人类评审队列,才是产品该做的事。
Multica 让 Agent 套用人类的协作方式,就像黑莓手机套用电脑的 QWERTY 键盘。

系统的核心只有两个状态转移函数。
Agent 是一个状态转移函数:session' = step(session, model, tools?)
它把当前 Session 交给 model,由 model 推理后决定下一步的 Session 长什么样。Agent 不循环、不常驻。它只在这个函数被调用时存在。
Trigger 也是一个状态转移函数:session' = trigger(session, event)
它把外部事件(用户消息、工具结果、定时器、Webhook 等)追加到 Session 中。Trigger 不调 model,不调工具,只负责更新 Session 的事件日志。
**Harness 是编排这它们的调度器。**每次 trigger 到来,由它执行一次完整的 load → trigger → step → save 生命周期,然后退出。
on trigger(session_id, event):
    session = load(session_id)
    session = trigger(session, event)        ← 注入事件
    session = step(session, model, tools?)    ← 模型处理
    save(session)
大部分框架的默认假设:一个 Agent = 一个容器。
Agent Loop + Browser + Terminal + Files 全部塞进同一个容器
问题是:生命周期完全不同的两种东西被绑在了一起。
一种是模型的思考:读消息、推理、决定调用工具。几十 MB 内存,挂了重启就行。
另一种是工具执行环境:Chrome、Node、Python、文件系统。几 GB,随时可能崩。
绑在一起带来两个问题:
故障。 容器崩了,状态和计算一起丢。
资源。 容器一直在线,Agent Loop 空等、工具环境空占,即使没有任务也在消耗资源。
解法是把两者拆开:状态(Session)持久化到存储,计算(模型推理、工具执行)按需拉起。
拆开之后,外部输入和模型推理自然变成两个独立的状态转移函数:Trigger 负责注入事件,Step 负责用模型更新 Session。两个函数各自独立、各自可替换、各自按需调度。
Trigger 是一个状态转移函数。输入 Session + 外部事件,输出更新后的 Session。
trigger(session, event):
    session.events.append(event)
    return session
不调 Model,不调 Tool。就是纯粹的状态更新。所有外部交互都是 Trigger,没有例外。
| 场景 | Trigger 类型 |
|---|---|
| 用户发消息 | UserMessage |
| 工具执行完 | ToolFinished |
| 定时器触发 | TimerExpired |
| 外部系统回调 | WebhookReceived |
| 上下文快满了 | ContextPressure |
| 人工审批通过 | HumanApproved |
| 子 Agent 完成 | AgentFinished |
传统 Agent 框架:
while True:
    think()
    act()
    observe()    ← 进程一直活着,占着内存,等着东西
这个模型:
不跑时 → 不存在
触发来 → 拉起 → 处理 → 保存 → 销毁
工具跑两小时:Model 已经下线了。用户三天没来:Session 在存储里,零资源消耗。
Agent 生命周期里没有“在线等待“这个状态。唯一的持久存在是 Session。
这是大规模调度的前提。 没有常驻的 Agent,就没有空转的资源。所有计算按需拉起、用完即毁。同一个 Harness 池可以服务数十万个 Session:谁被 trigger 唤醒就处理谁,处理完就接待下一个。资源利用率只取决于 trigger 频率,不取决于 Session 数量。
Harness 是整个运行时的调度器。它负责队列消费、触发优先级、状态持久化、现场恢复,以及编排两个状态转移函数。
Step 是 Harness 的执行单元。Model 是唯一必需的执行器,Tool 和 SubAgent 是可注入的能力:
纯对话 Agent:    step(session, model)
写代码 Agent:    step(session, model, [Terminal, FileSystem, Browser])
研究 Agent:      step(session, model, [Search, Browser, FileSystem])
从 Harness 视角看,SubAgent 就是一个 Tool:都是注入 step 的执行器,执行结果都以 trigger 返回。
一次 Harness 处理过程:
1. 从队列取出下一个 trigger
2. 恢复 Session(按策略:replay / summary / cold start)
   同时挂载 Workspace(外存,存放 Agent 产出的文件)
3. trigger 注入事件
4. step 调 Model、路由 Tool
   如果 model 发起工具调用,step 立即 dispatch 工具并结束。
   工具的结果通过触发器重新进入队列。
5. 写回 Session
6. 卸载 Workspace(可选)
7. 退出
Session 像内存,记录“做过什么、正在做什么“。Workspace 像外存,记录“产出了什么“——文件、代码、报告、数据。Workspace 不需要恢复,直接挂载即可。
Session 存储在事件日志中(类似内存),Workspace 存储在文件系统中(类似外存)。恢复主要针对 Session——Workspace 直接挂载即可,不需要重建。
三种恢复方式,对应 Trigger 加载 Session 的三种策略:
Replay:把完整的对话历史加载到 Session 中。适合短时间中断(KV Cache 还在,消息未冷)。
trigger_replay(session_id, event):
    session = load_full_history(session_id)
    session.events.append(event)
    return session
Summary:只加载压缩后的摘要,不加载完整历史。适合几小时到一天的中断。
trigger_summary(session_id, event):
    session = load_summary(session_id)
    session.events.append(event)
    return session
Cold Start:不加载 Session,只挂载 Workspace。Agent 通过读取工作区文件自己恢复现场。适合一天以上的中断。
trigger_cold_start(session_id, event):
    session = load_workspace(session_id)
    session.events.append(event)
    return session
恢复策略也可以由 Agent 自己提议。Agent 挂起前可以告诉 Harness 下次怎么唤醒它:
{
  "trigger": "ToolFinished",
  "resume_policy": {
    "strategy": "replay",
    "include_recent_events": 20
  }
}
Harness 有最终裁决权:Agent 提议,Harness 根据成本和时间间隔降级。
Session 会膨胀。100 万条 Event 之后,模型吃不下。
Harness 不替 Model 压缩,只提供信号:
ContextWindow 紧张
  → Trigger 发 ContextPressure 信号
  → Model 收到信号,自己决定怎么总结、压缩、归档
系统只有三个角色:
session' = step(session, model, tools?)。不循环、不常驻。session' = trigger(session, event)。统一外部输入。Anthropic 在 2026 年 4 月的 Engineering Blog《Scaling Managed Agents: Decoupling the brain from the hands》里把 Agent 拆成了三样东西:Session、Harness、Sandbox。
他们没有走到“Agent 是状态转移函数“这一步,但每一个设计决策:Session 持久化、Harness 无状态、Sandbox 远程化、事件驱动唤醒,都是同一个抽象的不同投影。