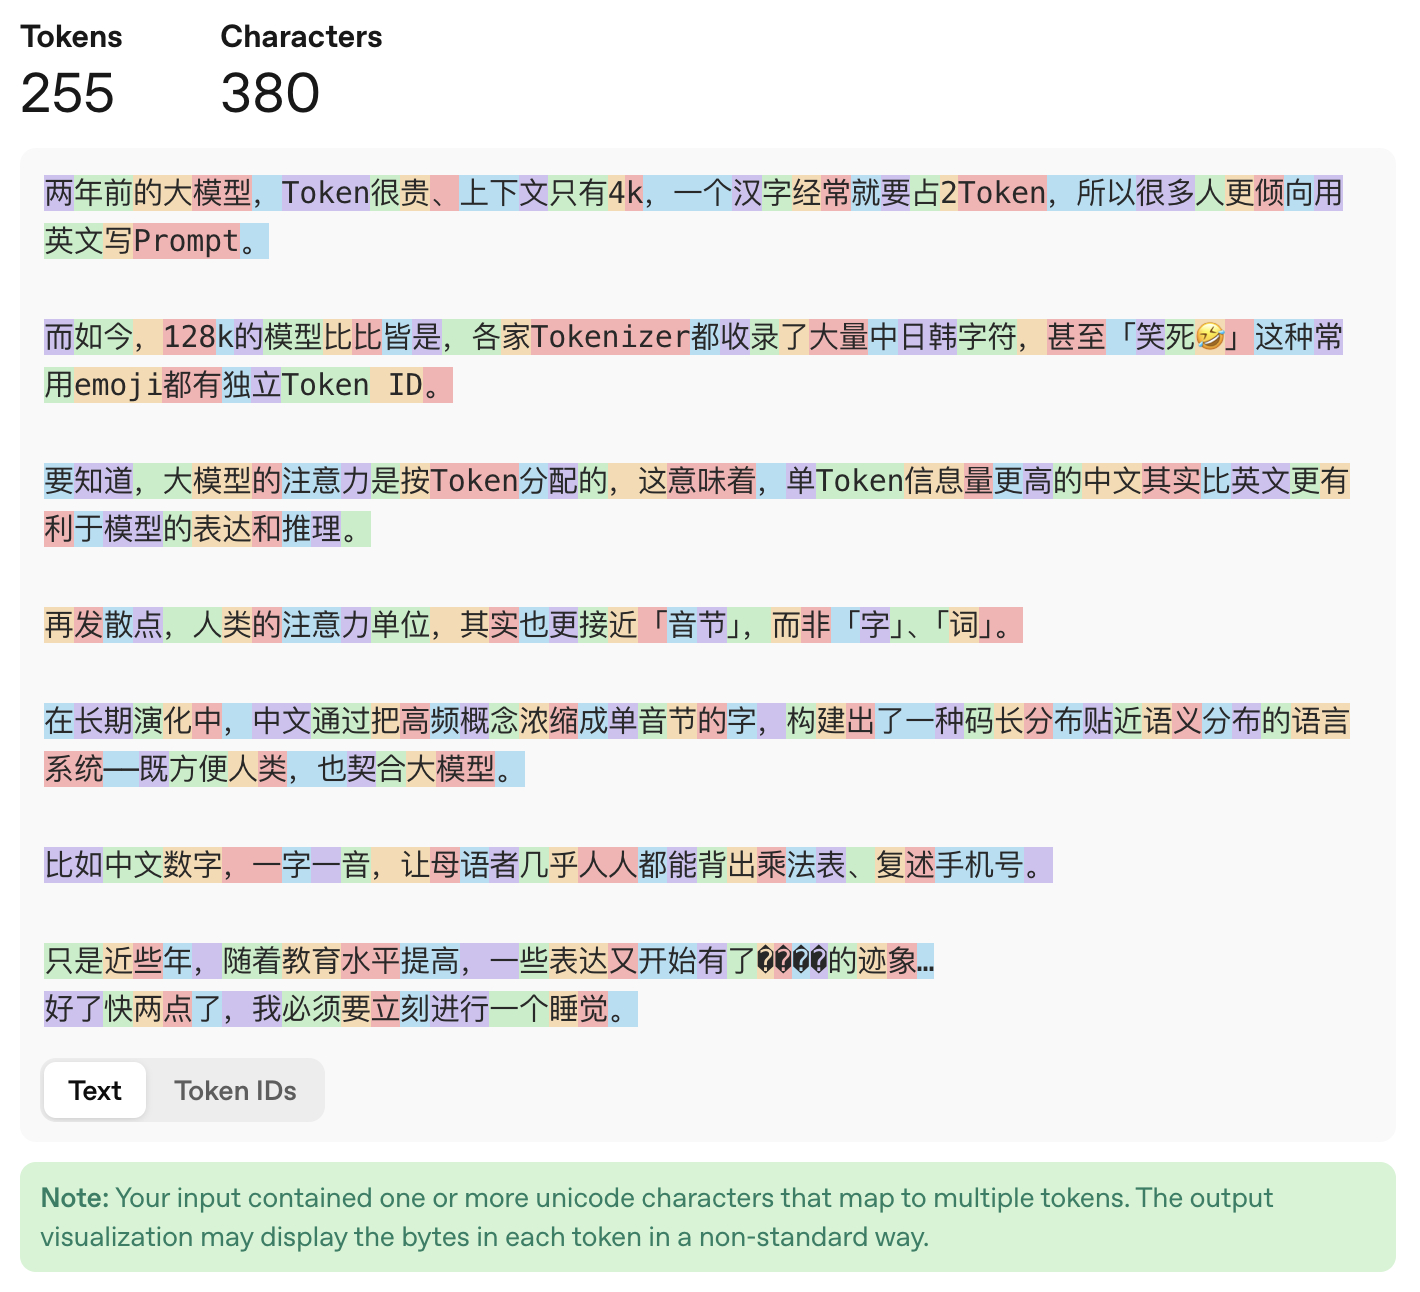
两年前的大模型,Token很贵、上下文只有4k,一个汉字经常就要占2Token,所以很多人更倾向用英文写Prompt。
而如今,128k的模型比比皆是,各家Tokenizer都收录了大量中日韩字符,甚至「笑死🤣」这种常用emoji都有独立Token ID。
要知道,大模型的注意力是按Token分配的,这意味着,单Token信息量更高的中文其实比英文更有利于模型的表达和推理。
再发散点,人类的注意力单位,其实也更接近「音节」,而非「字」、「词」。
在长期演化中,中文通过把高频概念浓缩成单音节的字,构建出了一种码长分布贴近语义分布的语言系统——既方便人类,也契合大模型。
比如中文数字,一字一音,让母语者几乎人人都能背出乘法表、复述手机号。
只是近些年,随着教育水平提高,一些表达又开始有了膨胀的迹象… 好了快两点了,我必须要立刻进行一个睡觉。