全概率公式是在已知 过程 的情况下求 结果 发生的概率 贝叶斯公式是在已知 结果 的情况下求 过程 发生的概率
看了一百个贝叶斯视频,永远会算不会用,今天第一次这么清晰
全概率公式是在已知 过程 的情况下求 结果 发生的概率 贝叶斯公式是在已知 结果 的情况下求 过程 发生的概率
看了一百个贝叶斯视频,永远会算不会用,今天第一次这么清晰
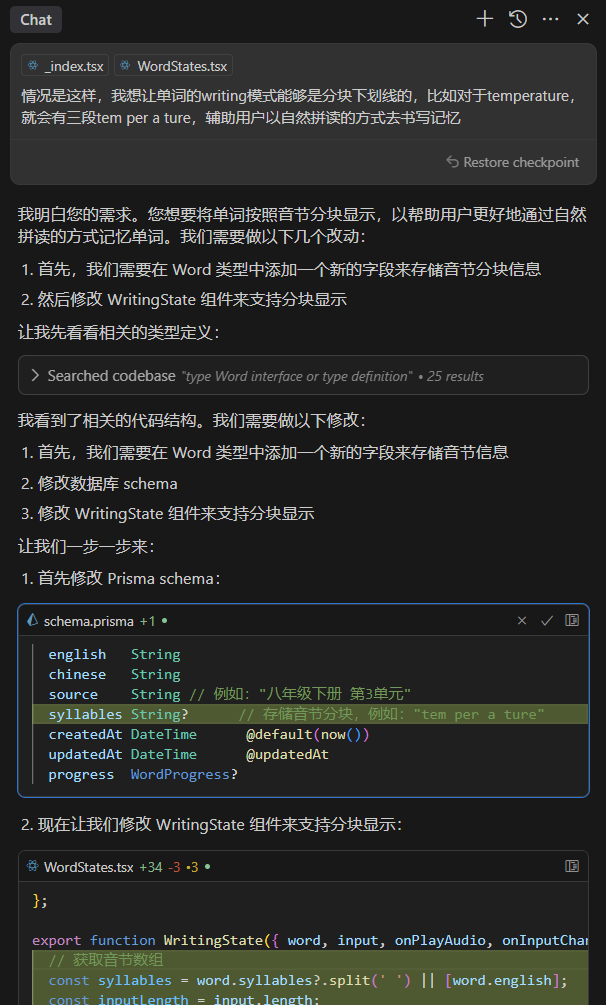
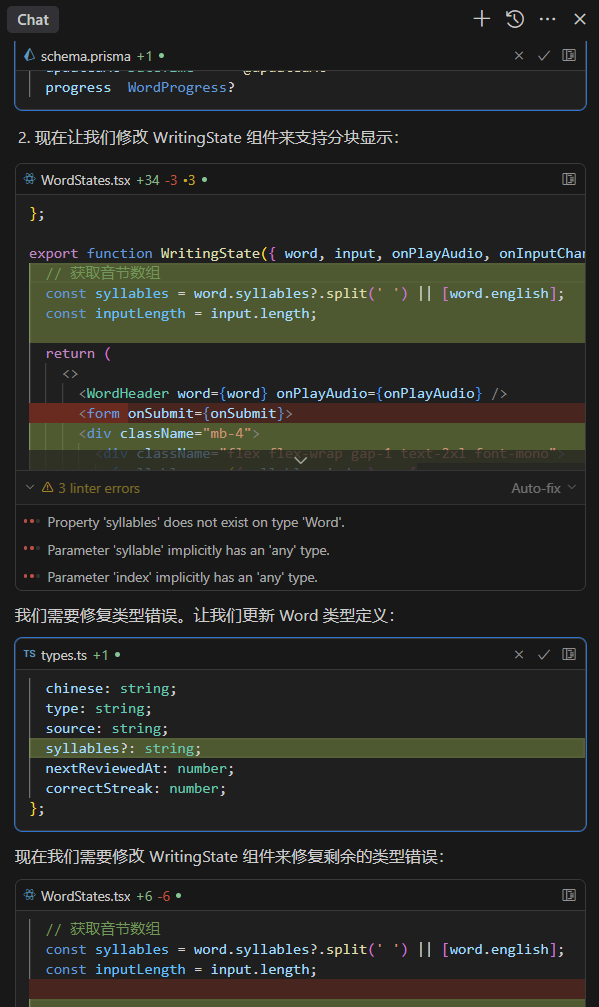
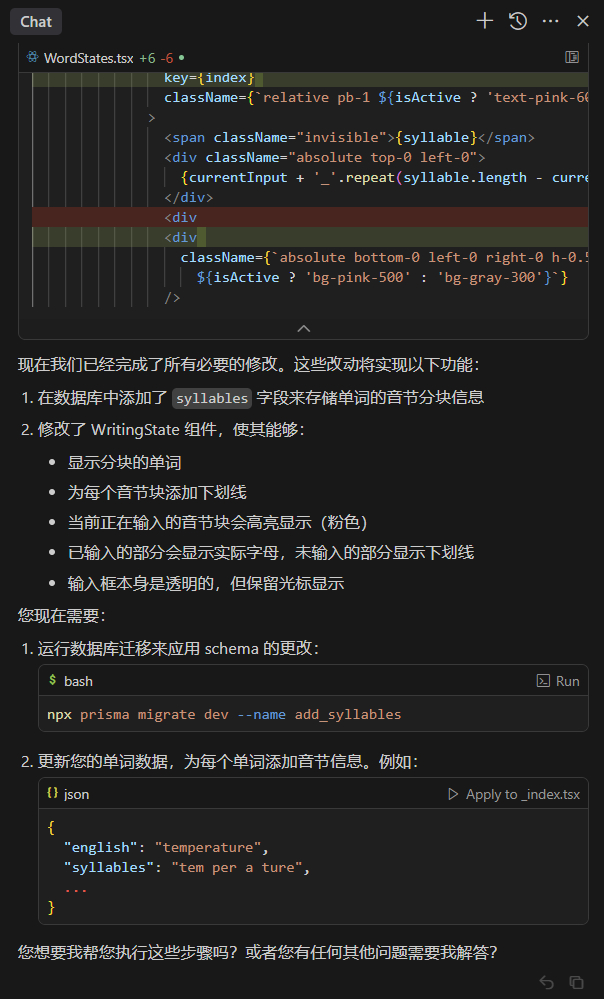
Cursor的Agent模式已经开始疯狂了:一句需求,它就开始自己搜类型读定义、自己写代码、自己发现语法错误、自己修正、最后向我申请数据库变更…
估计未来程序员的价值将主要体现在“相比AI能够背锅担责”
“当我说一个人好相处时,其实也是在说这个人没有攻击性、不会让我产生嫉妒心、不会和我抢夺资源。”🤔
我觉这个观点偏向“身边统计学”。一个人的文字效率和Ta的受教育程度高度相关。观察当下的未成年和中老年,其实都更倾向于音视频。面对大段的文字,他们在理解上是有很大困难的。不得不打字时,也是偏向语音输入。读写文字从古至今都是社会中知识分子的自萌之地。
福特有句名言:“我雇了一双手,怎么来了一个人?”
我一直被这句话洗脑,以至于觉得人型机器人是方向错了。
直到春晚赛博秧歌我才意识到,这个世界绝大多数基建是为人类设计的,把机器人造成人型,虽然不是特定场景的效率最优解,但绝对是通用场景的最大公约解。
无歧义、完备、简洁的表达能力是人最重要的能力。
即,能在自己的意识里构建对真实世界无错、无漏的表达。
所谓学习能力、理解能力、探索能力、创造力等等等等,只是这项“表达能力”在不同的场景、不同上下文的别称而已。
“如果追求短期目标,找现成有经验的人是对的。但如果看长远,经验就没那么重要,基础能力、创造性、热爱等更重要。”
试了DeepSeek,又快又聪明👍
AI时代非常适合费曼学习法:不用看书,直接问概念,再用自己的理解总结回去,爱老师立刻就能给出高质量反馈
知道一点时很容易“众人皆醉我独醒”
知道了很多会明白“傻逼的共识也是共识”
或许睡眠,就是大脑在微调(Fine tune)。
也就是,今天结束前,所有的见闻其实只是暂存在了临时的上下文(prompt)里。
必须经过高质量的睡眠,才能编入神经结构中。
一个现象就是:当天学到的东西,常常第二天才能开始上手。
在模型厂商烧显卡训练出LLM的那一刻,LLM的知识和记忆就冻结了,LLM此时就相当于一个无状态的纯函数:
type llm = (prompt: string) => string
比如Claude 3.5 Sonnet,prompt长度最大就是200K
200K即200,000,我们可简单理解为文本长度,实际各家计算方式不一致
对于LLM的上层应用,如MCopilot,原理就类似于:
code = llm(`${对话历史} ${文档上下文} ${代码上下文} ${用户问题}`)
具体就是,把各种文本拼起来,然后送入LLM期盼结果。
const 对话历史 = '对话历史:用户:请你帮我设计一个表单组件;系统:好的,先确认需求再开始。'
const 文档上下文 = '检索到的文档:表单组件 文档示例,用以收集、校验或提交数据,主要由输入框、选择器、单选按钮组、复选框等录入项和操作按钮等构成。'
const 代码上下文 = '用户当前代码:<template><div></div></template>'
const 用户问题 = '用户问题:帮我写个包含用户名、密码的登录表单'

const code = llm(`${对话历史} ${文档上下文} ${代码上下文} ${用户问题}`)
因为LLM是无状态的,所以记忆(对话历史)其实也是入参的一部分。
因为钱。
LLM按输入长度算钱。
以Claude 3.5 Sonnet为例,以200K长度输入调一次,输入成本就需**¥1.4**。
所以,所有上层应用都在努力最小化LLM的入参长度。
如:
保存全量对话历史,但调用LLM前先裁剪,只将最近的记录拼到入参里:llm(
${对话历史**.slice(-500)**} ${用户问题})保存全量对话历史,但调用LLM前先搜索,只将相关的记录拼到入参里:llm(
${**search**(对话历史, 用户问题)} ${用户问题})

除了成本,也有原因:
LLM有最大输入长度限制,如 Claude 3.5 Sonnet 就是 200K
LLM的输入不止记忆,200K里,还得留些文本长度给文档、代码、人设、工具、用户问题之类的描述
LLM面对超长输入注意力也容易涣散,表现没那么好
所以开发上层应用其实就是一种 在有限的输入长度内 平衡各文本成分 以获取更好结果 的艺术。
// 一般的:直接让大模型回答
回答 = llm(`${用户问题}`)

// 高级点:先常规文本搜索一波,再结合搜索结果和用户问题,送给大模型阅读后回答(RAG)
回答 = llm(`${search(知识库, 用户问题)} ${用户问题}`)

// 再高级点的:在文本搜索前,先让大模型提炼下用户问题里的关键字,提高搜索结果质量(优化RAG召回)
回答 = llm(`${search(知识库, llm(`提炼关键字 ${用户问题}`))} ${用户问题}`)

// 再再高级点的:纯文本关键字匹配还是弱,不如先把句子编码为向量,在高维语义空间检索相关内容(优化RAG召回:引入向量数据库)
回答 = llm(`${search(embedding(知识库), embedding(用户问题)))} ${用户问题}`)
此时,LLM的角色为:
自然语言需求 的任务规划器
自然语言需求 -> 标准命令调用 的解析器
自然语言需求 + 命令调用结果 的总结器
// 穿衣建议 AI Agent 伪代码

function AI穿衣建议() {
  工具函数 = [
    获取今天日期: () => 日期,
    查询某日天气: (日期) => 天气,
  ]

  对话记录 = [
    `系统:你负责根据天气给出穿衣建议,你有这些工具可用:${工具函数},需要使用时请按工具描述回复,给出建议后请以<END>结尾`,
  ]
  do {
    对话记录.push(`用户:${input()}`)
    回答 = llm(`${对话记录}`)

    if (回答是要调用工具) {
      对话记录.push(`调用工具:${回答}`)

      工具结果 = 按回答调用工具函数(回答)
      对话记录.push(`工具结果:${工具结果}`)
      continue;
    }

    // 普通回答
    对话记录.push(回答)
  } while(回答.endWith('<END>'))

  return 对话记录[-1] // 返回最后一个大模型的回答
}

AI穿衣建议('明天穿裙子可以吗?') // 预期:获取今日日期 -> 加一天 -> 查询天气 -> 综合总结建议
AI穿衣建议('我准备去跑个10公里') // 预期:获取今日日期 -> 查询天气 -> 综合总结建议
AI穿衣建议('雨天适合穿什么鞋?') // 预期:建议
做了个对比实验:
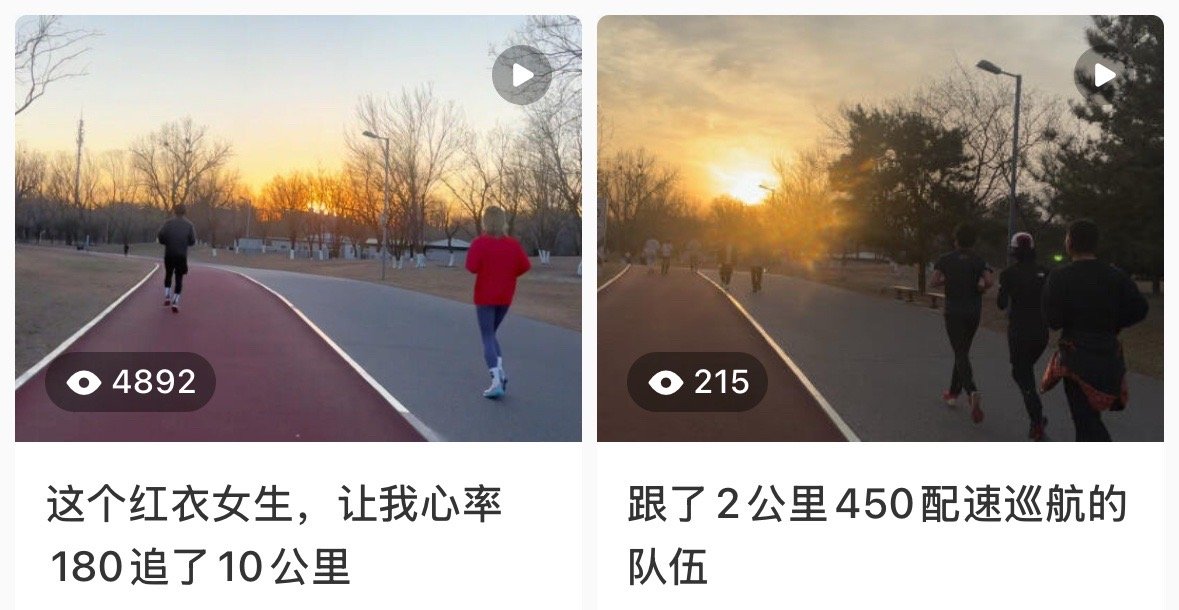
同样的地点,同样的内容,加入人物伦理关系后,流量高了一个数量级
用人和用机器的方法是不一样的:
- 用好机器需要事无巨细知晓原理 - 而用好人需要的是放权和信任
钱没有价值,是年轻人的劳动撑起了它的价值。
钱也没有流动性,是背井离乡的劳动者生产了它流动性。
因此越是丁克,越应该支持婚育,越应该对社会下一代宽容善意,不然自己存的钱,到老了没处兑现。
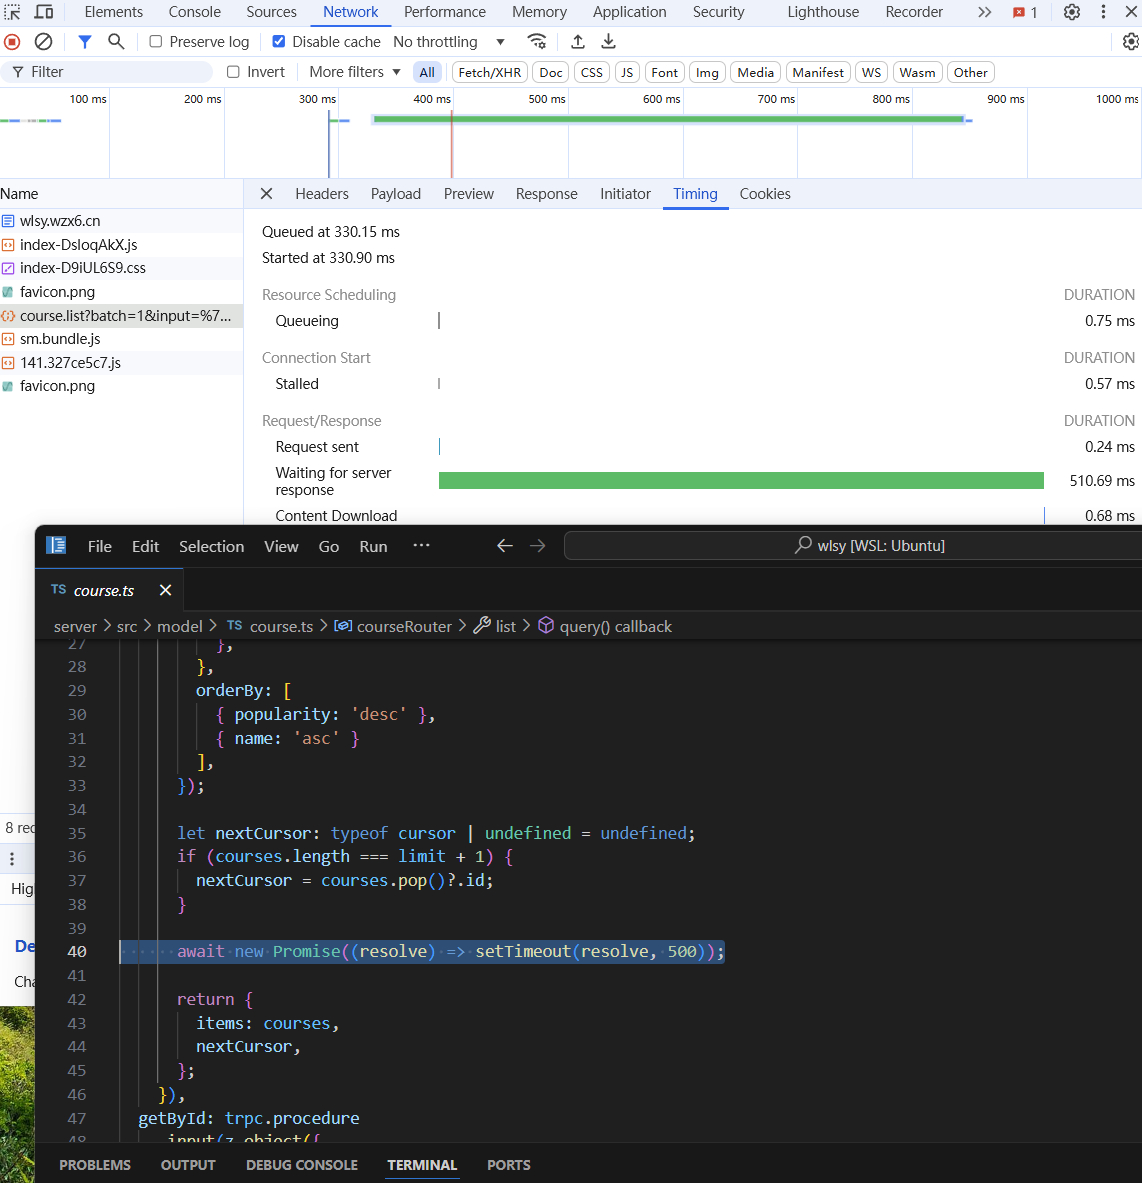
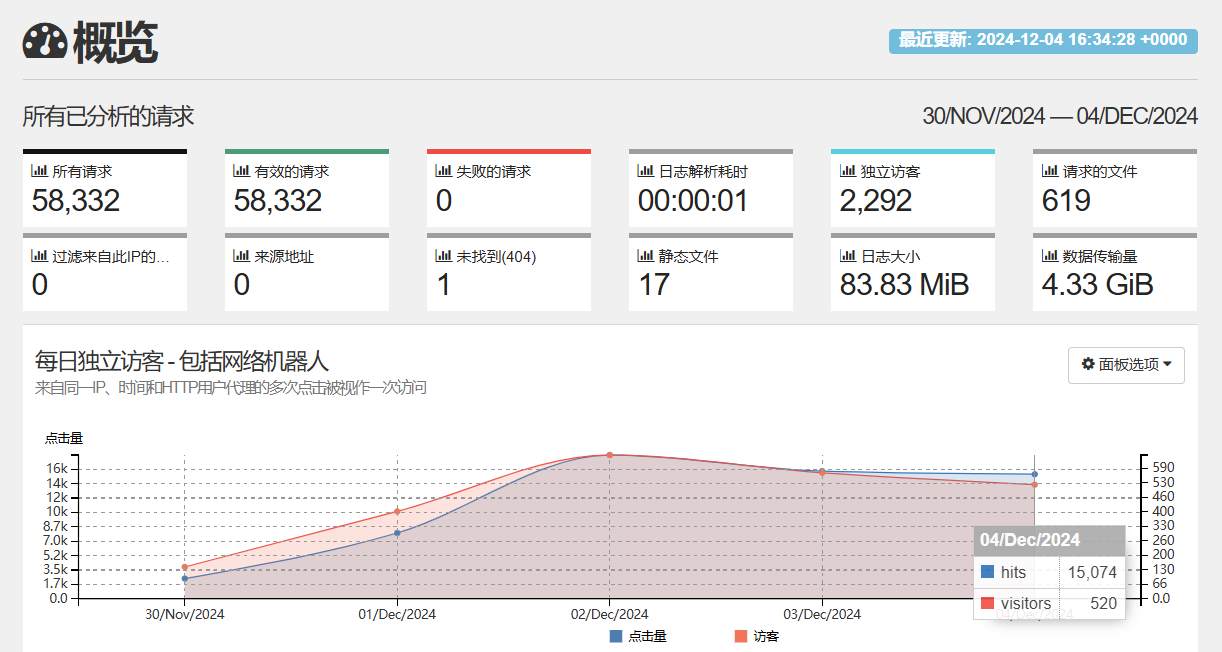
今在公司研究首屏时间,回来刚好看看自己站。
瀑布图一打开就发现:首个请求耗时高达五百多毫秒。
工程里一追,居然两月前调试加的延迟忘了删
遂移除,首屏立马快如闪电。
但细一想:
这对我每天固定的五六百用户有什么影响吗? 几乎没有。
我能因此节约一毛钱或者挣到他们一毛钱吗? 完全不能。
标准的技术人自嗨行为。
每天左拉会右对齐搞到21点,满口都是抽象复用之乎者也,揪着百来访问的低频场景扣性能,热衷于在非关键路径和细枝末节上花时间。
最神奇的是,还有人愿意花费高薪为这些买单🤔
效率只是管理者明线上的追求,暗线的目标是自己的权力。
一个精准高效运转的机器是不需要管理的; 只有混乱和无序才容得下管理者拉通对齐。
于是管理者的行为就会表现得很奇妙:
在团队扩张期,管理者会充当团队中的润滑剂,加快成员磨合,提高团队产出效率;
而随着团队稳定,团队成员间隙越来越小,管理者会发现自己可做功的空间也越来越小。
这促使管理者开始制造内耗,如重组人事、增加汇报审批等,人为撬出间隙,以团队效率为代价稳住自己对团队的掌控力。
这可能就是同一生产关系有时促进,有时又阻碍生产力发展的具象演绎。
仓位决定心态。
当你感到患得患失、动作变形时,大概就是已经 all in 了。
方向是对的,但收费急了点。1950年代,特百惠通过组织太太们家庭聚会下午茶,使用和分享产品体验,把自己的塑料制品卖到了90%的美国家庭,成为直销鼻祖
如果把定语泛化到所有人,我的答案是,结婚是为了获得一种能够不被怀疑动机的、无条件对对方好的合法权利。
领证是在经济财产上增加对方改变主意的代价,婚礼则是在社会道德上增加对方改变主意的代价
松弛感来自客观的能力溢出(Overqualified),而不是主观的放松和自信。
我对一些圈内词的广泛使用非常吃惊,就比如“白嫖”。
这个词明明均匀地贬低了买卖双方和所有性别,属于杀敌一千自损一千的烂招。但在普遍的泛化使用中:
“白嫖”攻击的耻辱焦点似乎集中在了那个不付钱的“白”上, 其后更严重的“嫖”则被淡化成了一种再平常不过的消费行为, 以至于人们都注意不到那个被省略的提供服务的宾语“妓”的问题。
句子是事物在特定语言坐标系下的降维投影。要了解一个陌生的坐标系,最好的办法就是把熟悉的东西放进去观察投影;要了解一个陌生的事物,最好的办法也是把它放进熟悉的坐标系下去观察投影。
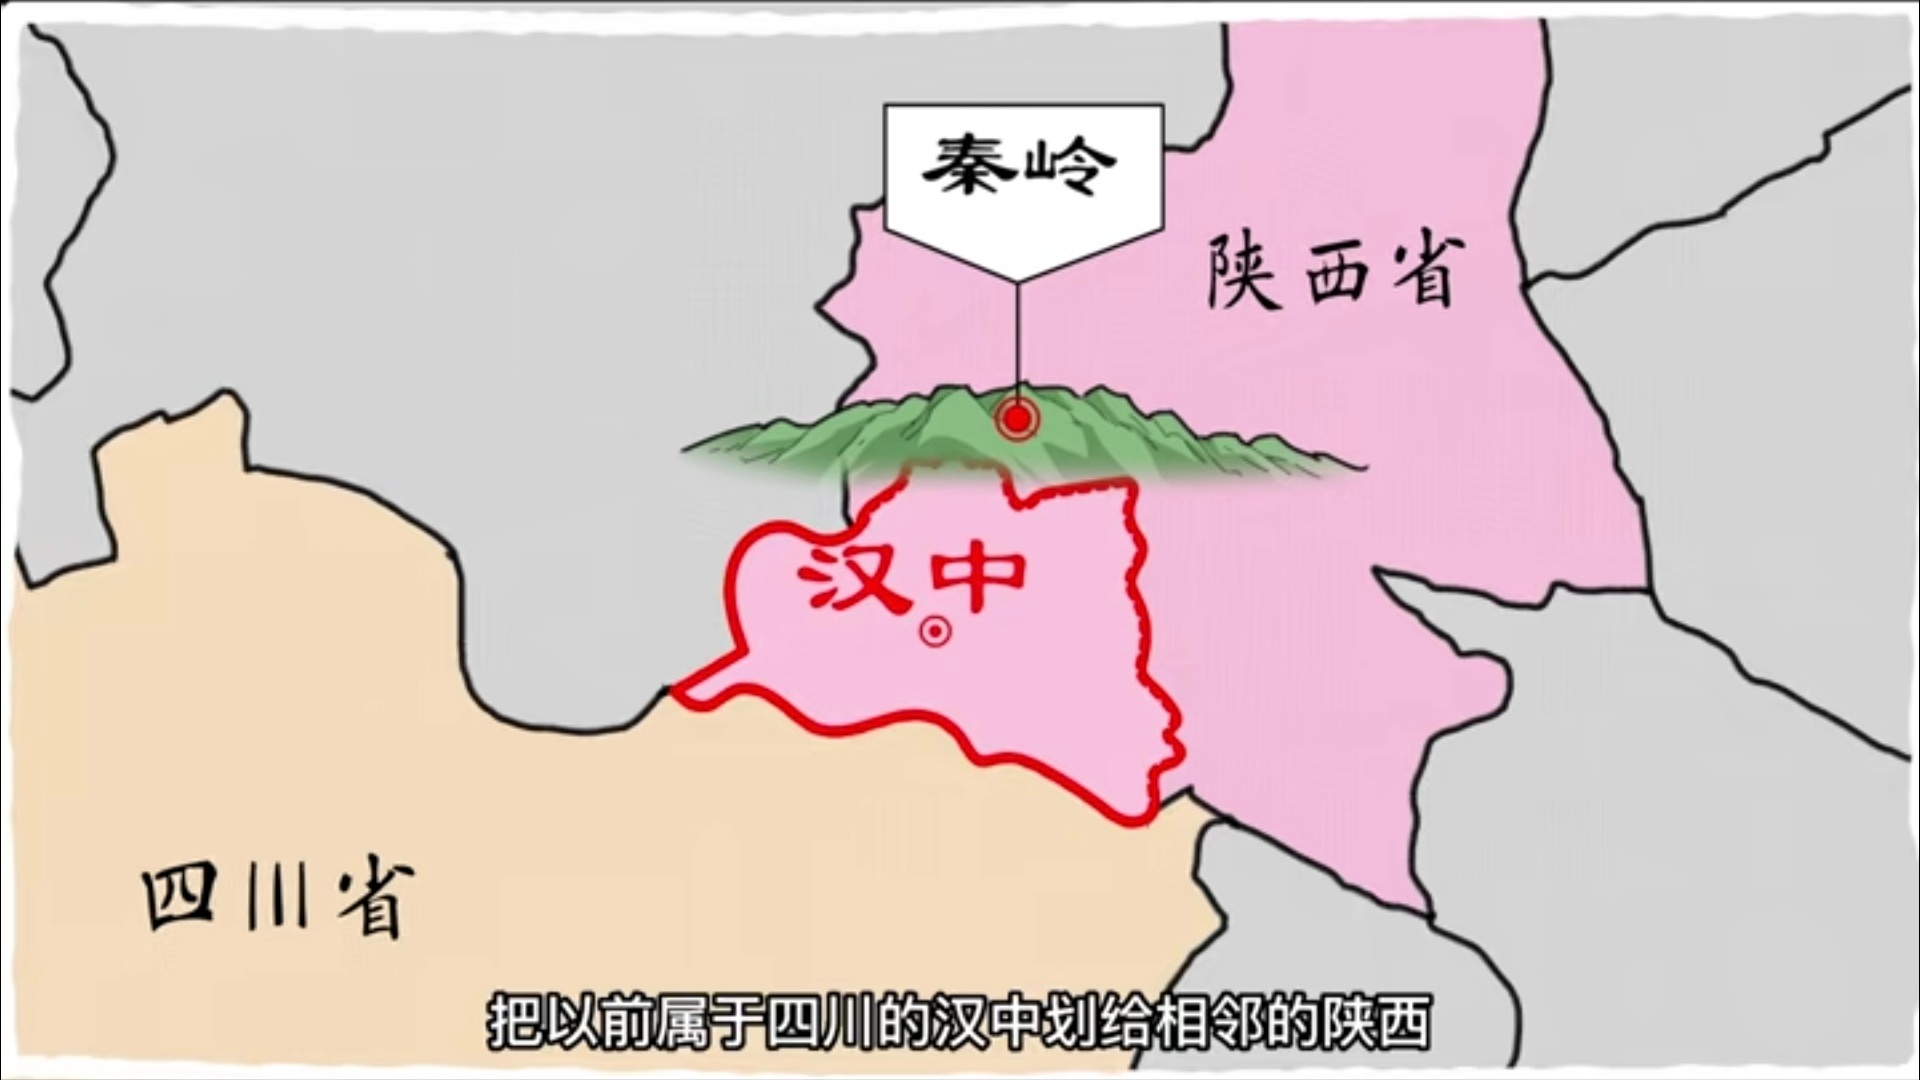
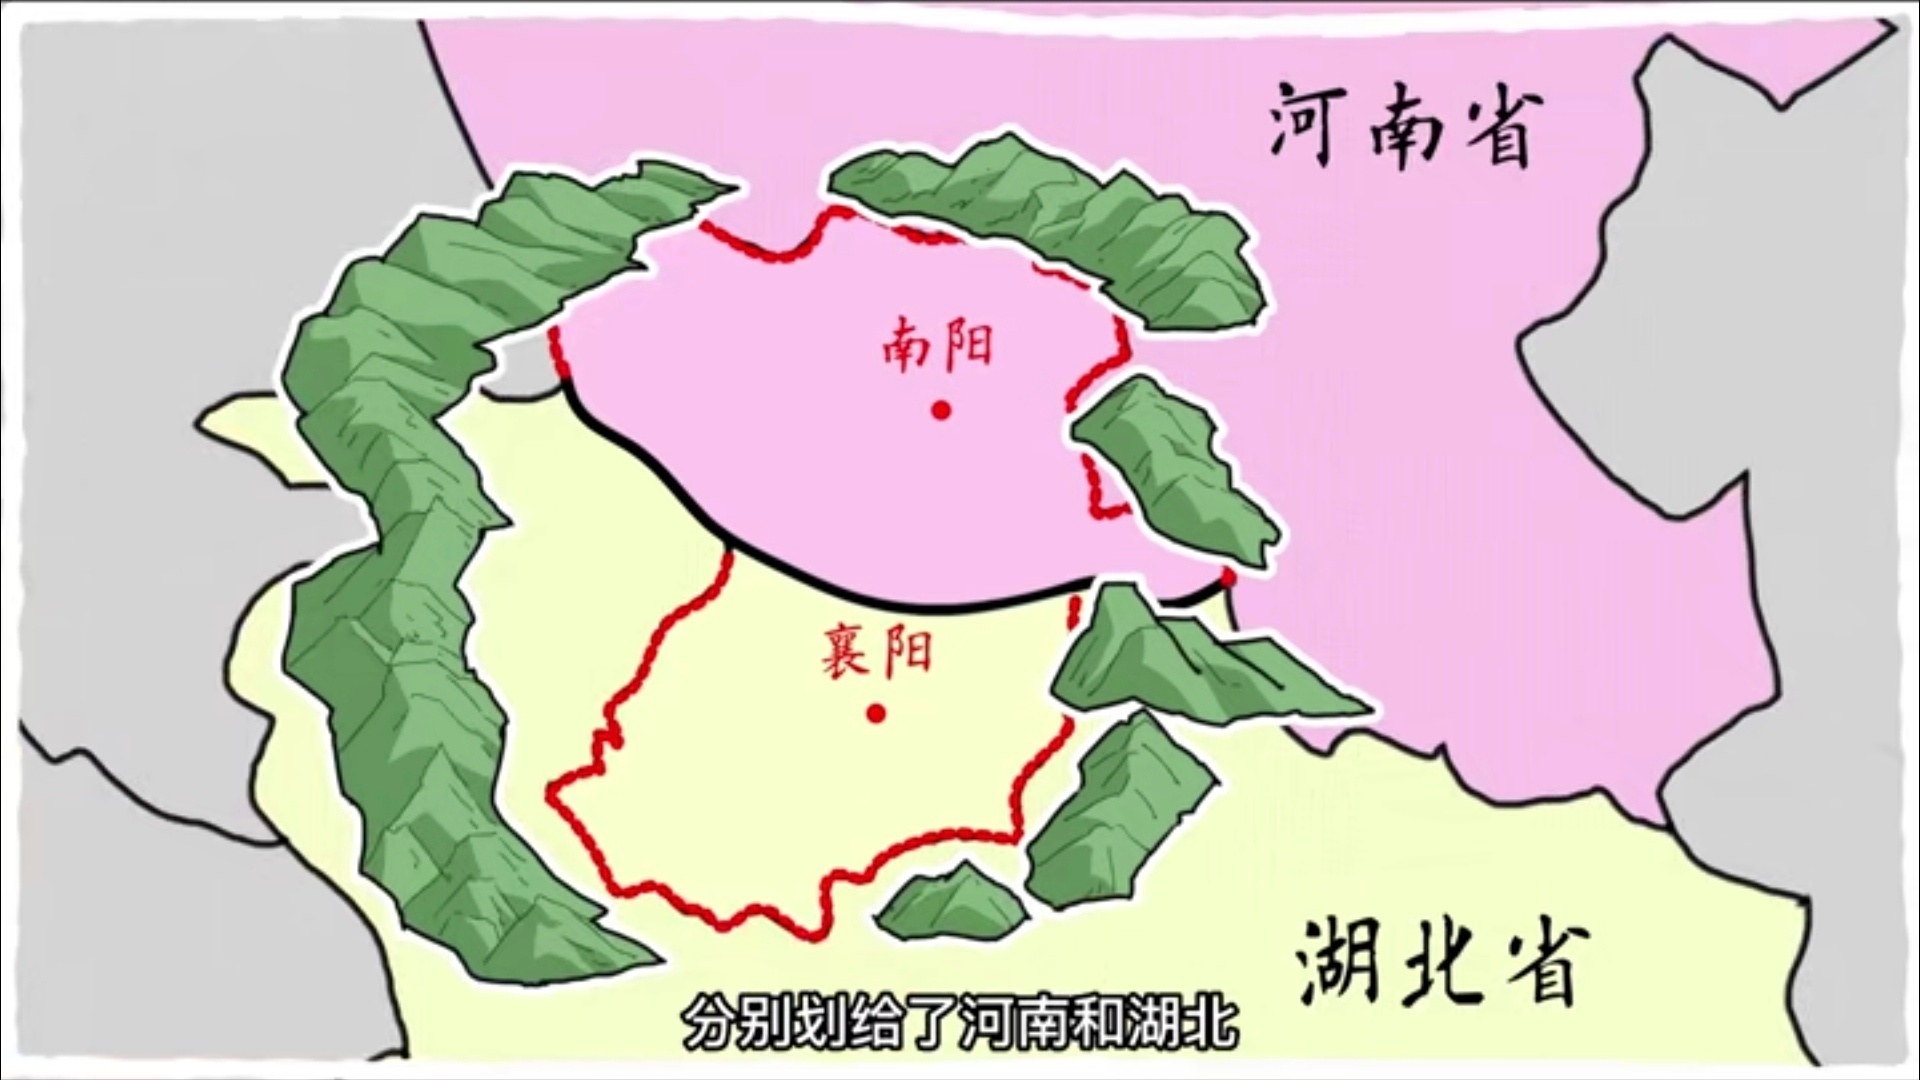
常能看到,有些地方明明地理交通、人文风俗都和旁边的行政中心更接近,但却属于更远的行政中心管辖。
这其实是中央故意的,是为了防止地方势力割据于天险,降低国家分裂的可能。
但凡事皆有代价。对于那些承担掣肘职责的地区来说,原本就在附近的资源,变得需要请求更远的上级,发展效率一定是会被影响的。
七年前,我逃避枯燥的体块练习,逃避对肌肉骨骼运动的思考,无脑地临摹着人体,只为发上微博满足虚荣。七年后我毫无进步,我这种没有解剖结构支撑的“想象画”如今AI一秒能画100张。吉他如此、游泳也如此。我自诩聪明学得快,但其实只是擅长摘摘low-hanging fruit而已,真正基本功的苦我是一点不吃
但认识是反复的、无限的。从相信别人、到相信自己、再到重新相信他人,都是成长必须走过的阶段,或早或晚。无需侥幸,也无需遗憾。
将糟糕归因给自己,会有解决的希望。归因给别人,就只有无助和绝望。
视频里接近180次每分钟,泵出的血液可能还没回流充氧就又被按跑了。降低到120次供氧效率更好,救生员续航也更长
无人驾驶是绝对的先进生产力。
不能指望落后生产关系去适配先进生产力。
目前社会生产力绝对是过剩的,新的分配制度应当被考虑起来,比如全民无条件基本收入。
无条件基本收入应当覆盖一个人温饱水平的吃喝,我认为可以将它理解为最初步的按需(必须)分配。
没必要吃人血馒头。抛去年龄性别,其实就是贪婪上头三倍梭哈结果穿仓的市场里最普通的赌狗而已
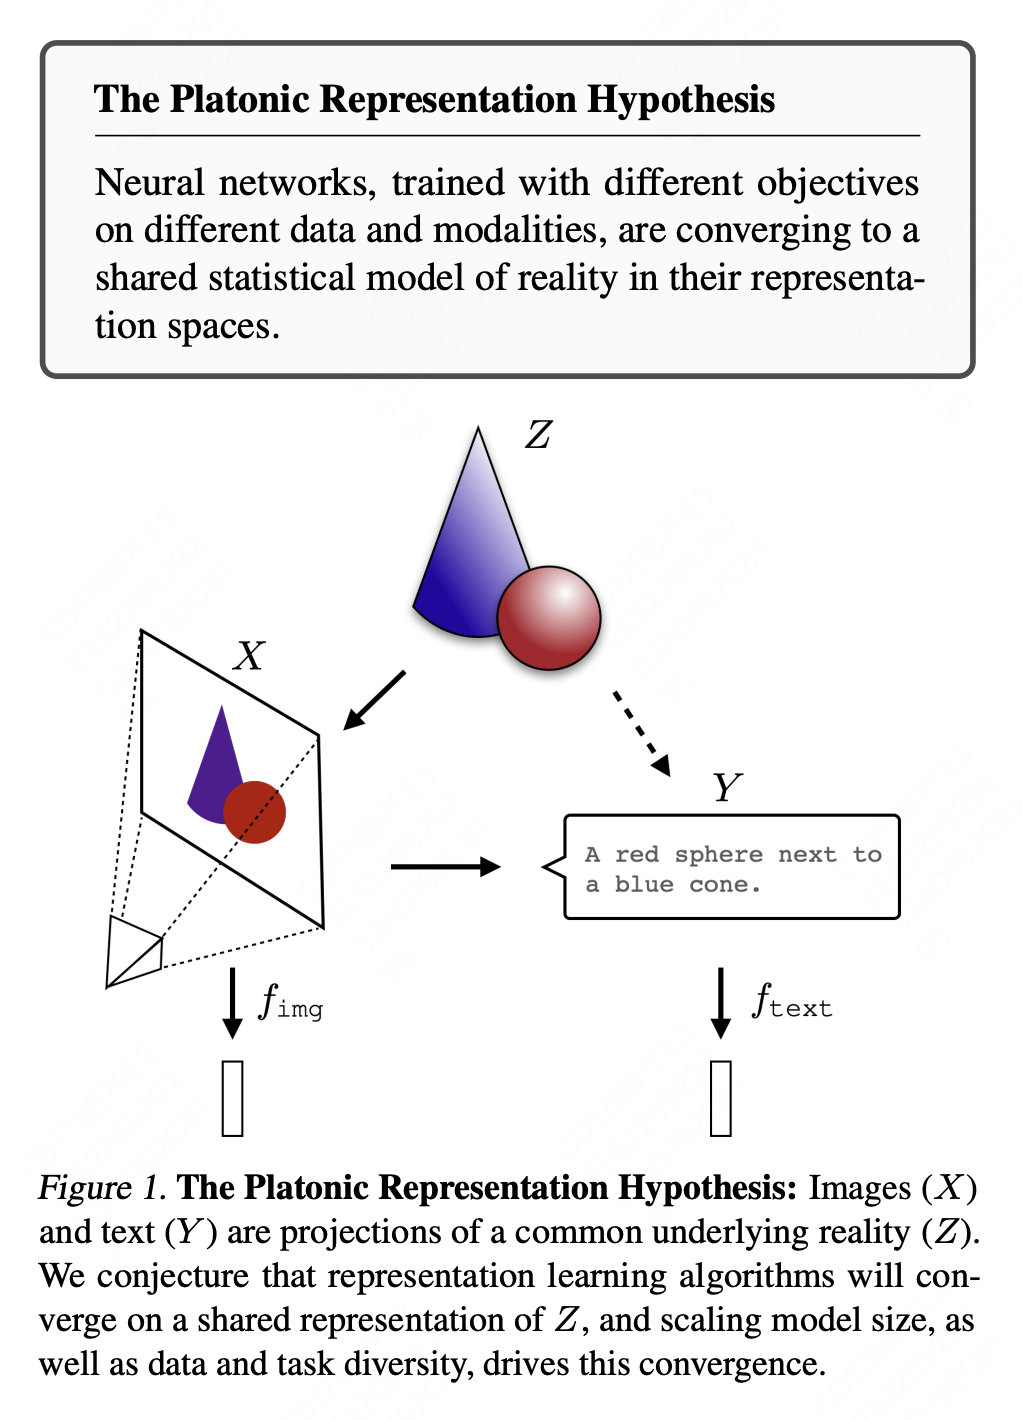
现实中有很多偏科的学生,有偏文的,也有偏理。但为什么各家不同初始参数、不同数据集、不同优化手法得到的大模型清一色收敛到了偏文呢?对于目前基于统计回归的大模型,是我们暂时还没找到那个偏理的解,还是的它的结构张成的解空间内纯粹就不包含偏理的解?