Zexi's Notes

Markdown ↗

对大语言模型(LLM)应用的理解

为什么LLM记不住历史?

在模型厂商烧显卡训练出LLM的那一刻,LLM的知识和记忆就冻结了,LLM此时就相当于一个无状态的纯函数:

type llm = (prompt: string) => string

比如Claude 3.5 Sonnet,prompt长度最大就是200K
200K即200,000,我们可简单理解为文本长度,实际各家计算方式不一致

那上层应用的记忆是怎么实现的?

对于LLM的上层应用,如MCopilot,原理就类似于:

code = llm(`${对话历史} ${文档上下文} ${代码上下文} ${用户问题}`)

具体就是,把各种文本拼起来,然后送入LLM期盼结果。

const 对话历史 = '对话历史:用户:请你帮我设计一个表单组件;系统:好的,先确认需求再开始。'
const 文档上下文 = '检索到的文档:表单组件 文档示例,用以收集、校验或提交数据,主要由输入框、选择器、单选按钮组、复选框等录入项和操作按钮等构成。'
const 代码上下文 = '用户当前代码:<template><div></div></template>'
const 用户问题 = '用户问题:帮我写个包含用户名、密码的登录表单'

const code = llm(`${对话历史} ${文档上下文} ${代码上下文} ${用户问题}`)

因为LLM是无状态的,所以记忆(对话历史)其实也是入参的一部分。

每次都拼上历史记忆很难吗,为什么还是一关闭就忘光?

因为钱。

LLM按输入长度算钱。

以Claude 3.5 Sonnet为例,以200K长度输入调一次,输入成本就需**¥1.4**。

所以,所有上层应用都在努力最小化LLM的入参长度。

如:

  • 保存全量对话历史,但调用LLM前先裁剪,只将最近的记录拼到入参里:llm(${对话历史**.slice(-500)**} ${用户问题})

  • 保存全量对话历史,但调用LLM前先搜索,只将相关的记录拼到入参里:llm(${**search**(对话历史, 用户问题)} ${用户问题})

够了,我有钱。

image.jpeg

除了成本,也有原因:

  • LLM有最大输入长度限制,如 Claude 3.5 Sonnet 就是 200K

  • LLM的输入不止记忆,200K里,还得留些文本长度给文档、代码、人设、工具、用户问题之类的描述

  • LLM面对超长输入注意力也容易涣散,表现没那么好

所以开发上层应用其实就是一种 在有限的输入长度内 平衡各文本成分 以获取更好结果 的艺术。

应用案例

智能客服

// 一般的:直接让大模型回答
回答 = llm(`${用户问题}`)

// 高级点:先常规文本搜索一波,再结合搜索结果和用户问题,送给大模型阅读后回答(RAG)
回答 = llm(`${search(知识库, 用户问题)} ${用户问题}`)

// 再高级点的:在文本搜索前,先让大模型提炼下用户问题里的关键字,提高搜索结果质量(优化RAG召回)
回答 = llm(`${search(知识库, llm(`提炼关键字 ${用户问题}`))} ${用户问题}`)

// 再再高级点的:纯文本关键字匹配还是弱,不如先把句子编码为向量,在高维语义空间检索相关内容(优化RAG召回:引入向量数据库)
回答 = llm(`${search(embedding(知识库), embedding(用户问题)))} ${用户问题}`)

智能代理(AI Agent)

此时,LLM的角色为:

  • 自然语言需求 的任务规划器

  • 自然语言需求 -> 标准命令调用 的解析器

  • 自然语言需求 + 命令调用结果 的总结器

// 穿衣建议 AI Agent 伪代码

function AI穿衣建议() {
  工具函数 = [
    获取今天日期: () => 日期,
    查询某日天气: (日期) => 天气,
  ]

  对话记录 = [
    `系统:你负责根据天气给出穿衣建议,你有这些工具可用:${工具函数},需要使用时请按工具描述回复,给出建议后请以<END>结尾`,
  ]
  do {
    对话记录.push(`用户:${input()}`)
    回答 = llm(`${对话记录}`)

    if (回答是要调用工具) {
      对话记录.push(`调用工具:${回答}`)

      工具结果 = 按回答调用工具函数(回答)
      对话记录.push(`工具结果:${工具结果}`)
      continue;
    }

    // 普通回答
    对话记录.push(回答)
  } while(回答.endWith('<END>'))
  
  return 对话记录[-1] // 返回最后一个大模型的回答
}

AI穿衣建议('明天穿裙子可以吗?') // 预期:获取今日日期 -> 加一天 -> 查询天气 -> 综合总结建议
AI穿衣建议('我准备去跑个10公里') // 预期:获取今日日期 -> 查询天气 -> 综合总结建议
AI穿衣建议('雨天适合穿什么鞋?') // 预期:建议

做了个对比实验:

同样的地点,同样的内容,加入人物伦理关系后,流量高了一个数量级[哆啦A梦害怕] ​​​

配图 1

用人和用机器的方法是不一样的:

- 用好机器需要事无巨细知晓原理 - 而用好人需要的是放权和信任 ​​​

钱没有价值,是年轻人的劳动撑起了它的价值。

钱也没有流动性,是背井离乡的劳动者生产了它流动性。

因此越是丁克,越应该支持婚育,越应该对社会下一代宽容善意,不然自己存的钱,到老了没处兑现。 ​​​

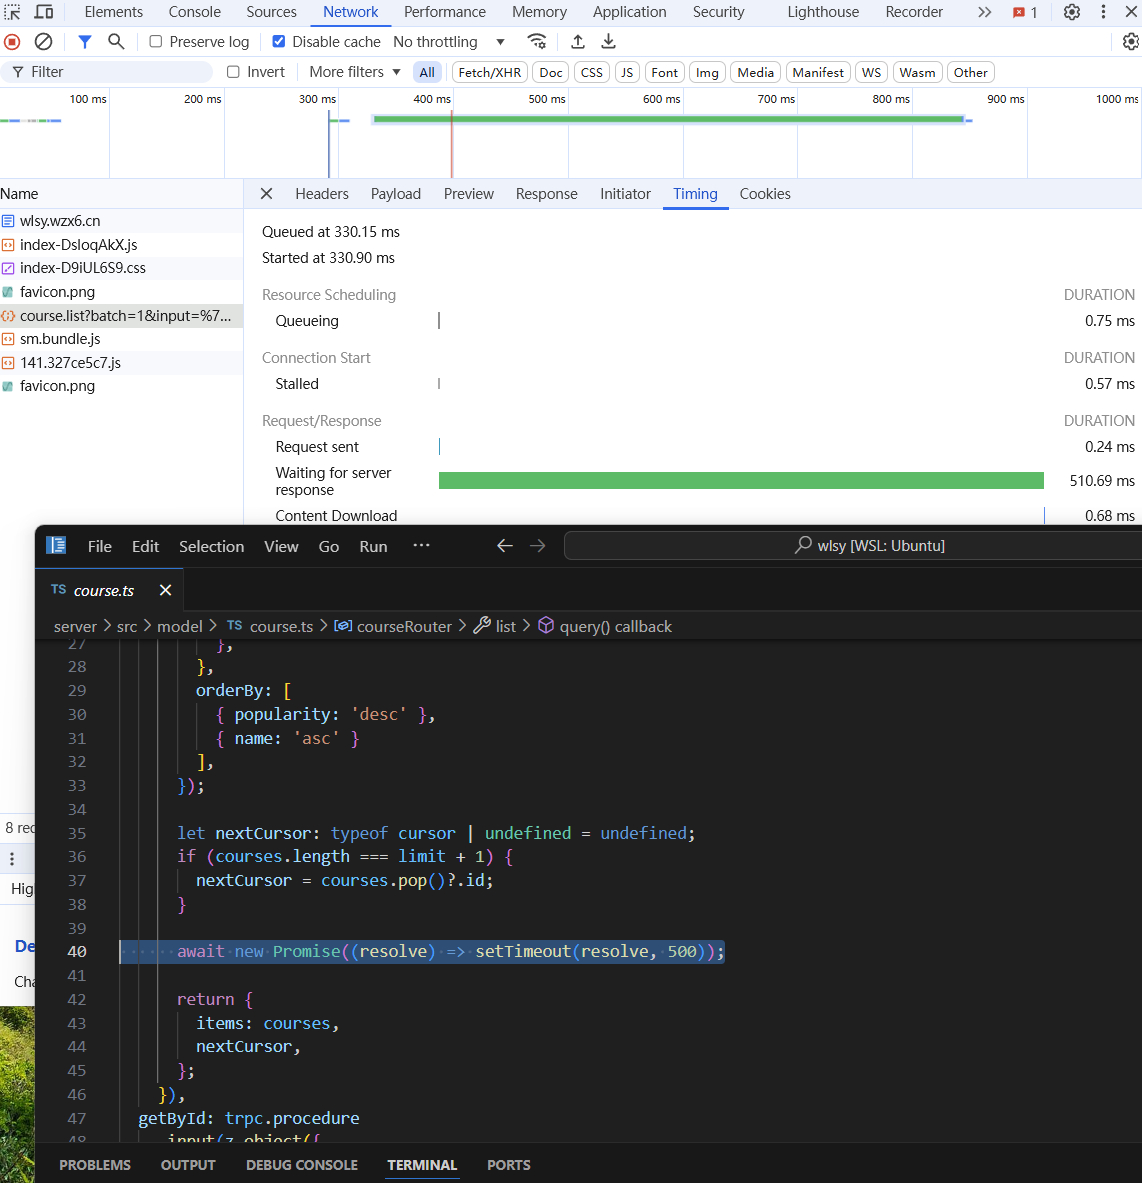
今在公司研究首屏时间,回来刚好看看自己站。

瀑布图一打开就发现:首个请求耗时高达五百多毫秒。 工程里一追,居然两月前调试加的延迟忘了删[汗]

遂移除,首屏立马快如闪电。

但细一想:

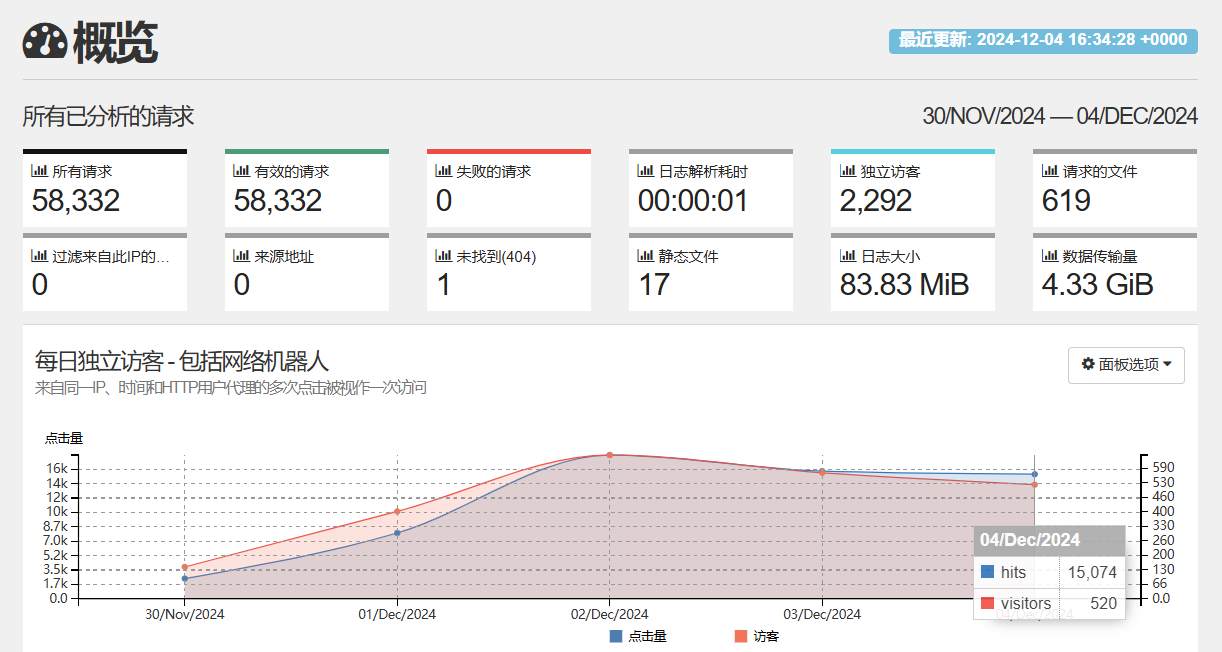
这对我每天固定的五六百用户有什么影响吗? 几乎没有。

我能因此节约一毛钱或者挣到他们一毛钱吗? 完全不能。

标准的技术人自嗨行为。

每天左拉会右对齐搞到21点,满口都是抽象复用之乎者也,揪着百来访问的低频场景扣性能,热衷于在非关键路径和细枝末节上花时间。

最神奇的是,还有人愿意花费高薪为这些买单🤔

配图 1配图 2

效率只是管理者明线上的追求,暗线的目标是自己的权力。

一个精准高效运转的机器是不需要管理的; 只有混乱和无序才容得下管理者拉通对齐。

于是管理者的行为就会表现得很奇妙:

在团队扩张期,管理者会充当团队中的润滑剂,加快成员磨合,提高团队产出效率;

而随着团队稳定,团队成员间隙越来越小,管理者会发现自己可做功的空间也越来越小。

这促使管理者开始制造内耗,如重组人事、增加汇报审批等,人为撬出间隙,以团队效率为代价稳住自己对团队的掌控力。

这可能就是同一生产关系有时促进,有时又阻碍生产力发展的具象演绎。

仓位决定心态。

当你感到患得患失、动作变形时,大概就是已经 all in 了。 ​​​

方向是对的,但收费急了点。1950年代,特百惠通过组织太太们家庭聚会下午茶,使用和分享产品体验,把自己的塑料制品卖到了90%的美国家庭,成为直销鼻祖

如果把定语泛化到所有人,我的答案是,结婚是为了获得一种能够不被怀疑动机的、无条件对对方好的合法权利。

领证是在经济财产上增加对方改变主意的代价,婚礼则是在社会道德上增加对方改变主意的代价[思考]

松弛感来自客观的能力溢出(Overqualified),而不是主观的放松和自信。 ​​​

我对一些圈内词的广泛使用非常吃惊,就比如“白嫖”。

这个词明明均匀地贬低了买卖双方和所有性别,属于杀敌一千自损一千的烂招。但在普遍的泛化使用中:

“白嫖”攻击的耻辱焦点似乎集中在了那个不付钱的“白”上, 其后更严重的“嫖”则被淡化成了一种再平常不过的消费行为, 以至于人们都注意不到那个被省略的提供服务的宾语“妓”的问题。

句子是事物在特定语言坐标系下的降维投影。要了解一个陌生的坐标系,最好的办法就是把熟悉的东西放进去观察投影;要了解一个陌生的事物,最好的办法也是把它放进熟悉的坐标系下去观察投影。

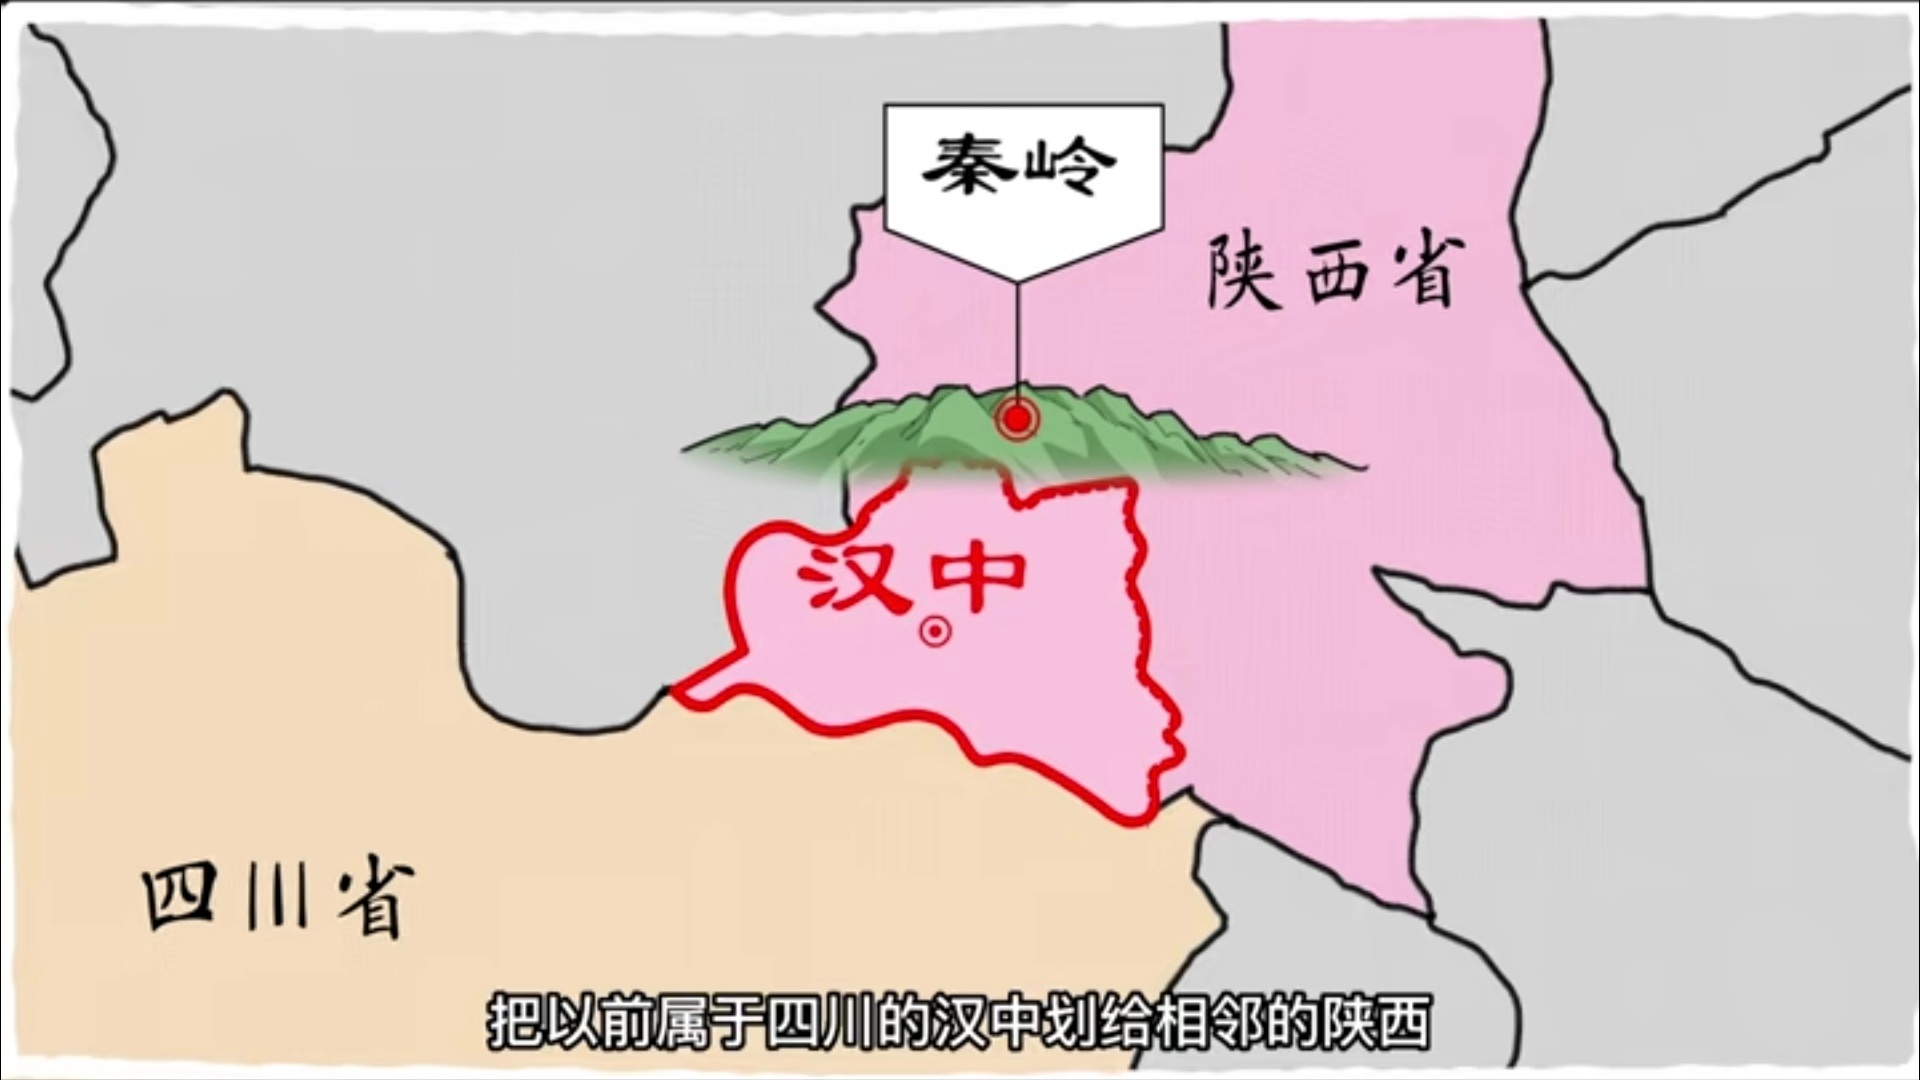
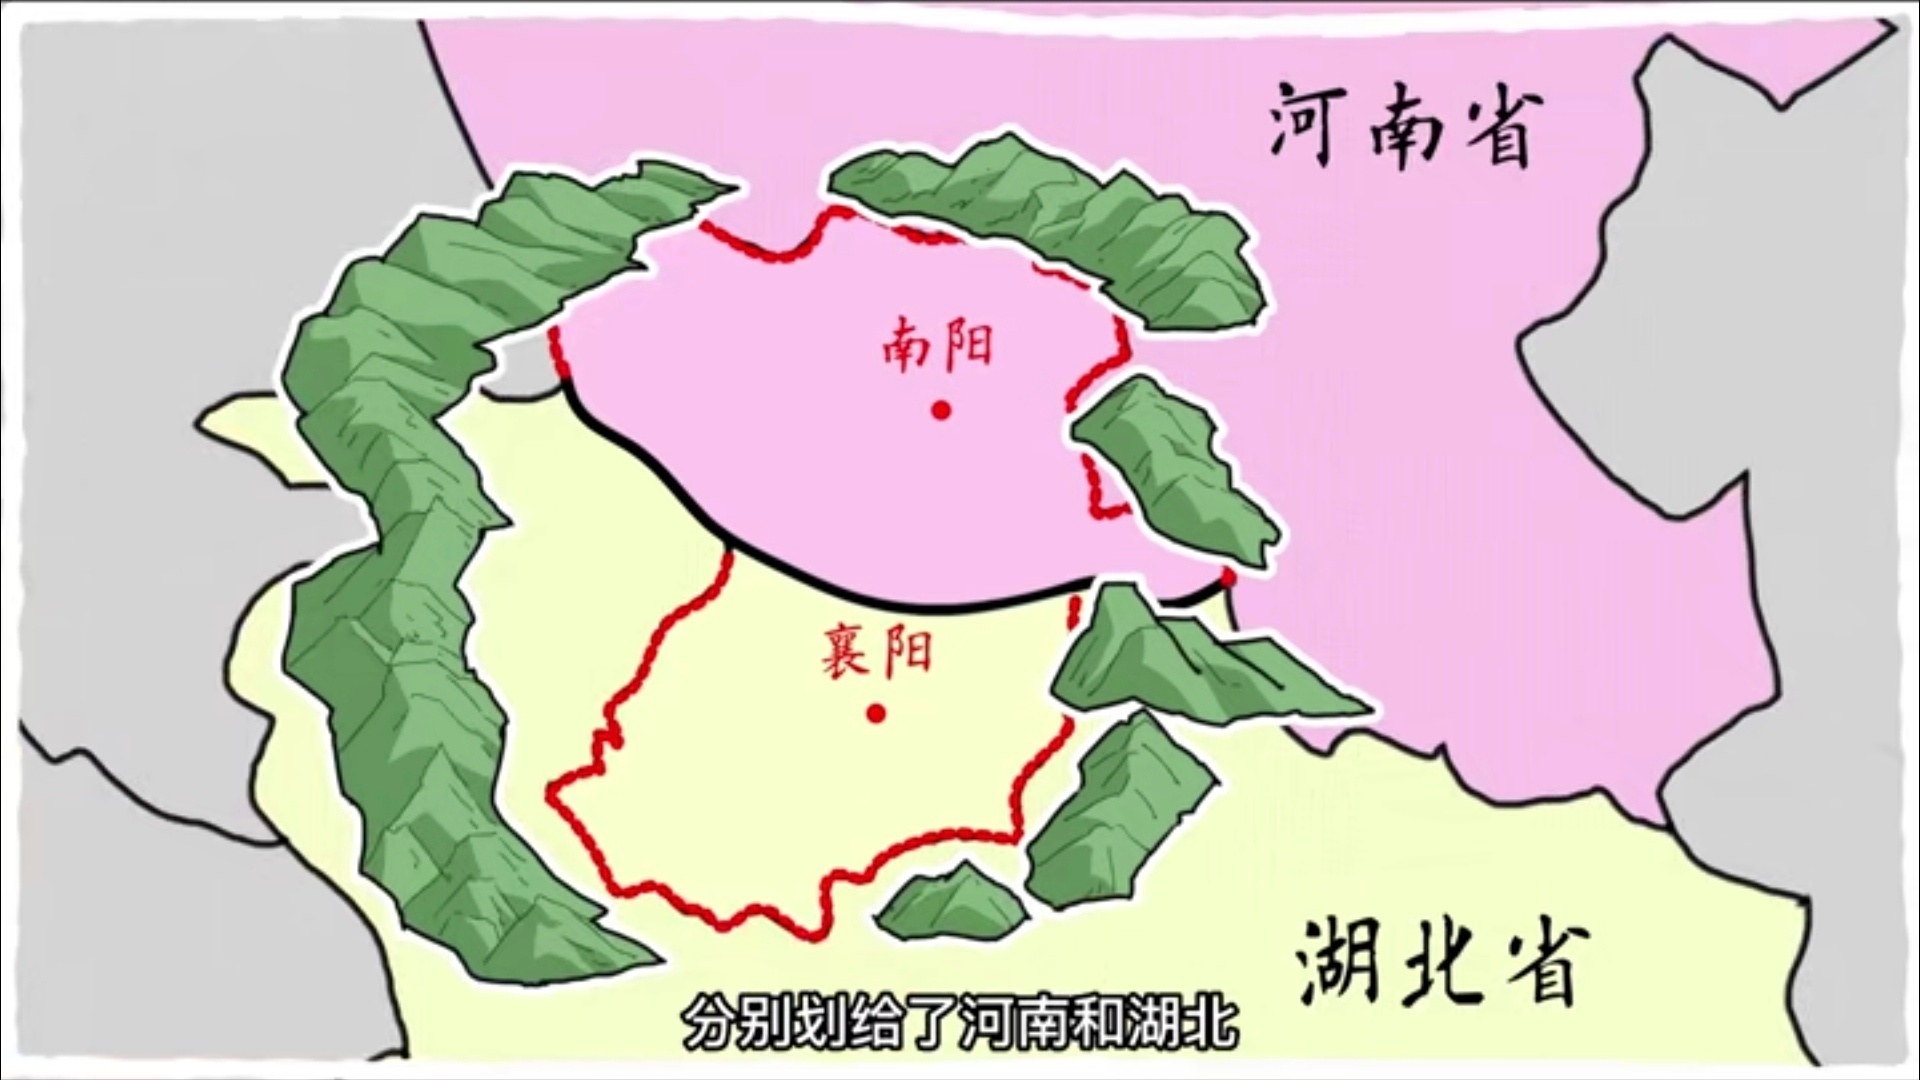
常能看到,有些地方明明地理交通、人文风俗都和旁边的行政中心更接近,但却属于更远的行政中心管辖。

这其实是中央故意的,是为了防止地方势力割据于天险,降低国家分裂的可能。

但凡事皆有代价。对于那些承担掣肘职责的地区来说,原本就在附近的资源,变得需要请求更远的上级,发展效率一定是会被影响的。

配图 1配图 2

七年前,我逃避枯燥的体块练习,逃避对肌肉骨骼运动的思考,无脑地临摹着人体,只为发上微博满足虚荣。七年后我毫无进步,我这种没有解剖结构支撑的“想象画”如今AI一秒能画100张。吉他如此、游泳也如此。我自诩聪明学得快,但其实只是擅长摘摘low-hanging fruit而已,真正基本功的苦我是一点不吃[赞]

但认识是反复的、无限的。从相信别人、到相信自己、再到重新相信他人,都是成长必须走过的阶段,或早或晚。无需侥幸,也无需遗憾。

将糟糕归因给自己,会有解决的希望。归因给别人,就只有无助和绝望。

视频里接近180次每分钟,泵出的血液可能还没回流充氧就又被按跑了。降低到120次供氧效率更好,救生员续航也更长[你好]

无人驾驶是绝对的先进生产力。

不能指望落后生产关系去适配先进生产力。

目前社会生产力绝对是过剩的,新的分配制度应当被考虑起来,比如全民无条件基本收入。

无条件基本收入应当覆盖一个人温饱水平的吃喝,我认为可以将它理解为最初步的按需(必须)分配。 ​​​

没必要吃人血馒头。抛去年龄性别,其实就是贪婪上头三倍梭哈结果穿仓的市场里最普通的赌狗而已

现实中有很多偏科的学生,有偏文的,也有偏理。但为什么各家不同初始参数、不同数据集、不同优化手法得到的大模型清一色收敛到了偏文呢?对于目前基于统计回归的大模型,是我们暂时还没找到那个偏理的解,还是的它的结构张成的解空间内纯粹就不包含偏理的解?[思考]

当手机承接下大多数娱乐需求后,电脑就特化成了专业设备[思考]

周知:上午11点后拉30分钟以上的会,其实相当于120分钟——30分钟会、90分钟饭点高峰

17点同理。 ​​​

贪图享乐是人的天性。

你利用这份弱点,以自己的付出为饵换取对方的青睐,营造与你在一起对方只需要享乐的幻觉,本就是在走捷径。

若对方没有给你理想中的回报就要报复,就要追责。

你可能觉得你很正义,也很容易在网上找到很多人来给你叫好。

但如果你一开始就把你这一套写清楚拿大牌子举着,你看看谁愿意和你来往?

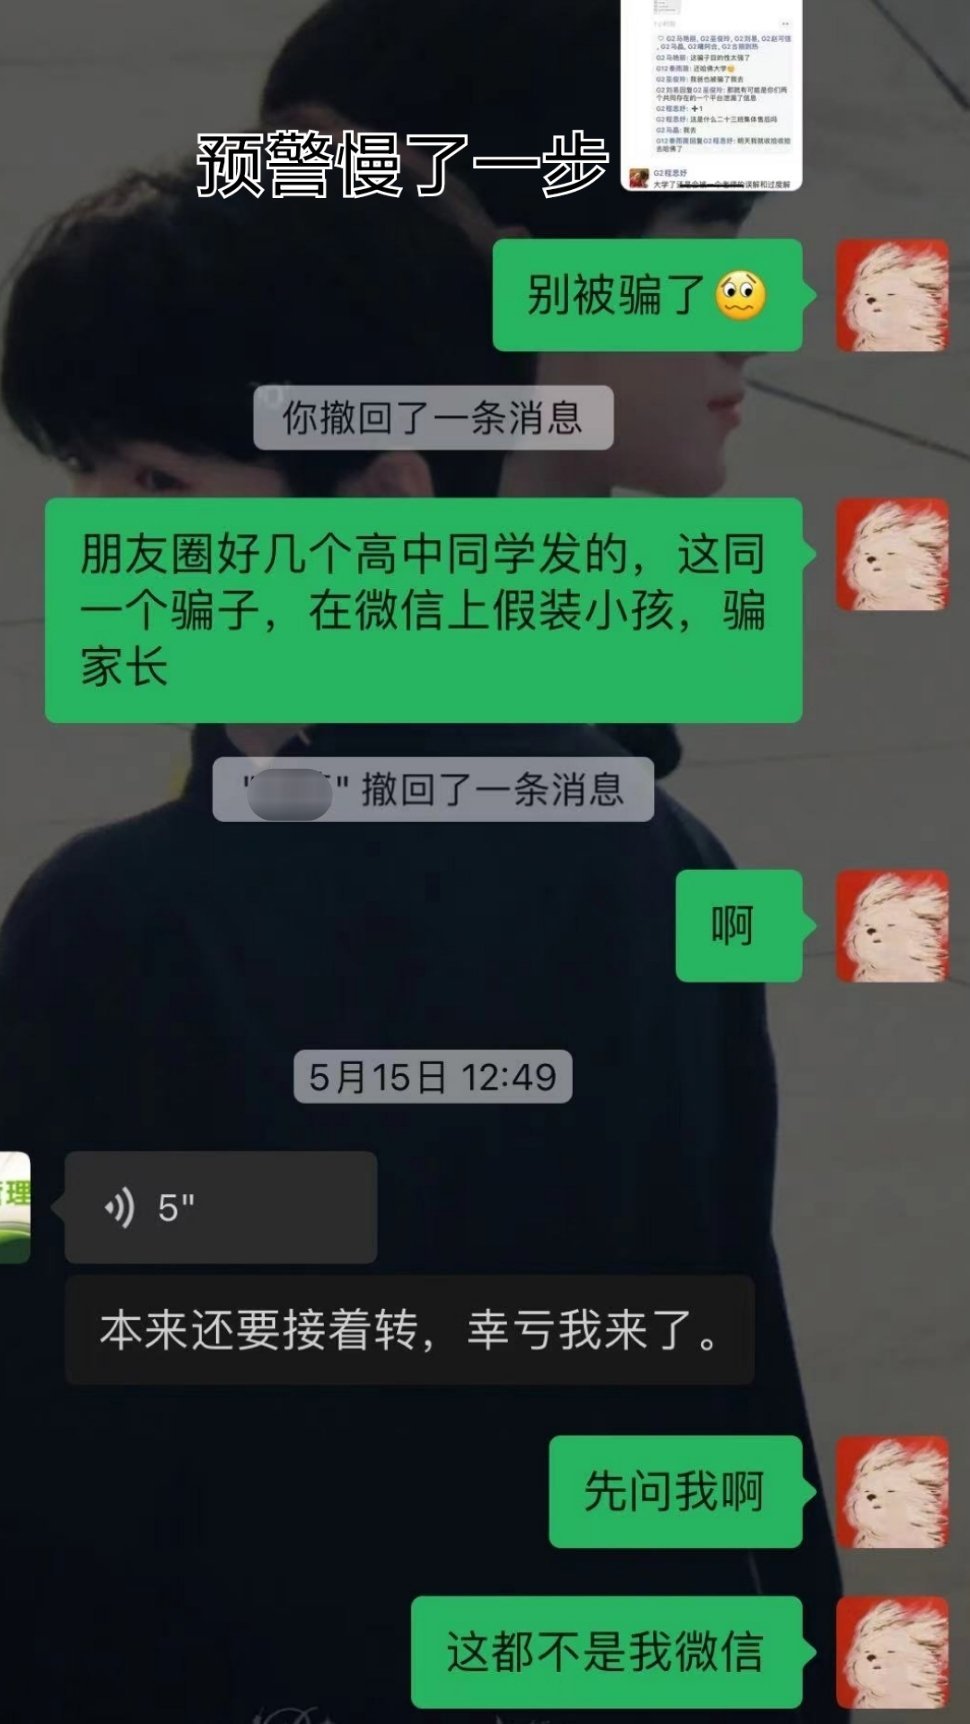
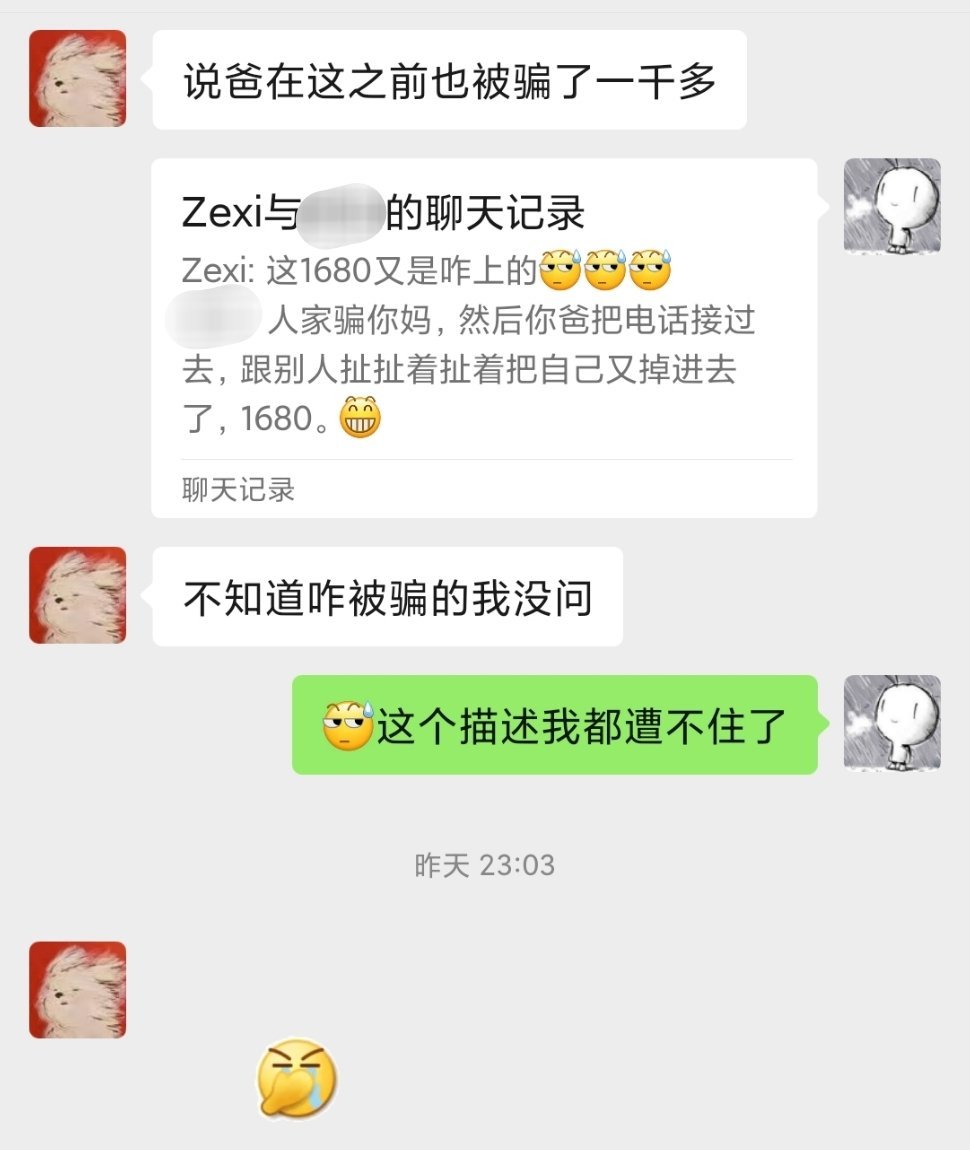
@你Zexi不是天才 获悉,两周前有人仿冒妹妹微信名称头像添加妈妈以报名培训为由骗走五万元。

为什么骗子选择冒充妹妹? 因为妹妹是大学新生,正好被骗子的剧本命中。

为什么妈妈没有识别出骗子? 因为家里平常就是微信打字,有事说事,和骗子一样机械。

为什么是五万元? 因为微信单日转账上限是五万。

为什么妈妈没有与我二次确认/为什么两周后我才被动知道? 因为家里平常沟通频次较低,导致占用对方时间发起对话的心理成本被推得很高。

为什么反诈案例我在家年年讲、常常发,还是被骗了? 因为我作为家里接受教育时间最长的人,在向家庭输出正外部性这项应尽的义务上,流于形式了,偷懒了。

这次是培训进修,下次呢? 这次有微信限额,下次呢?

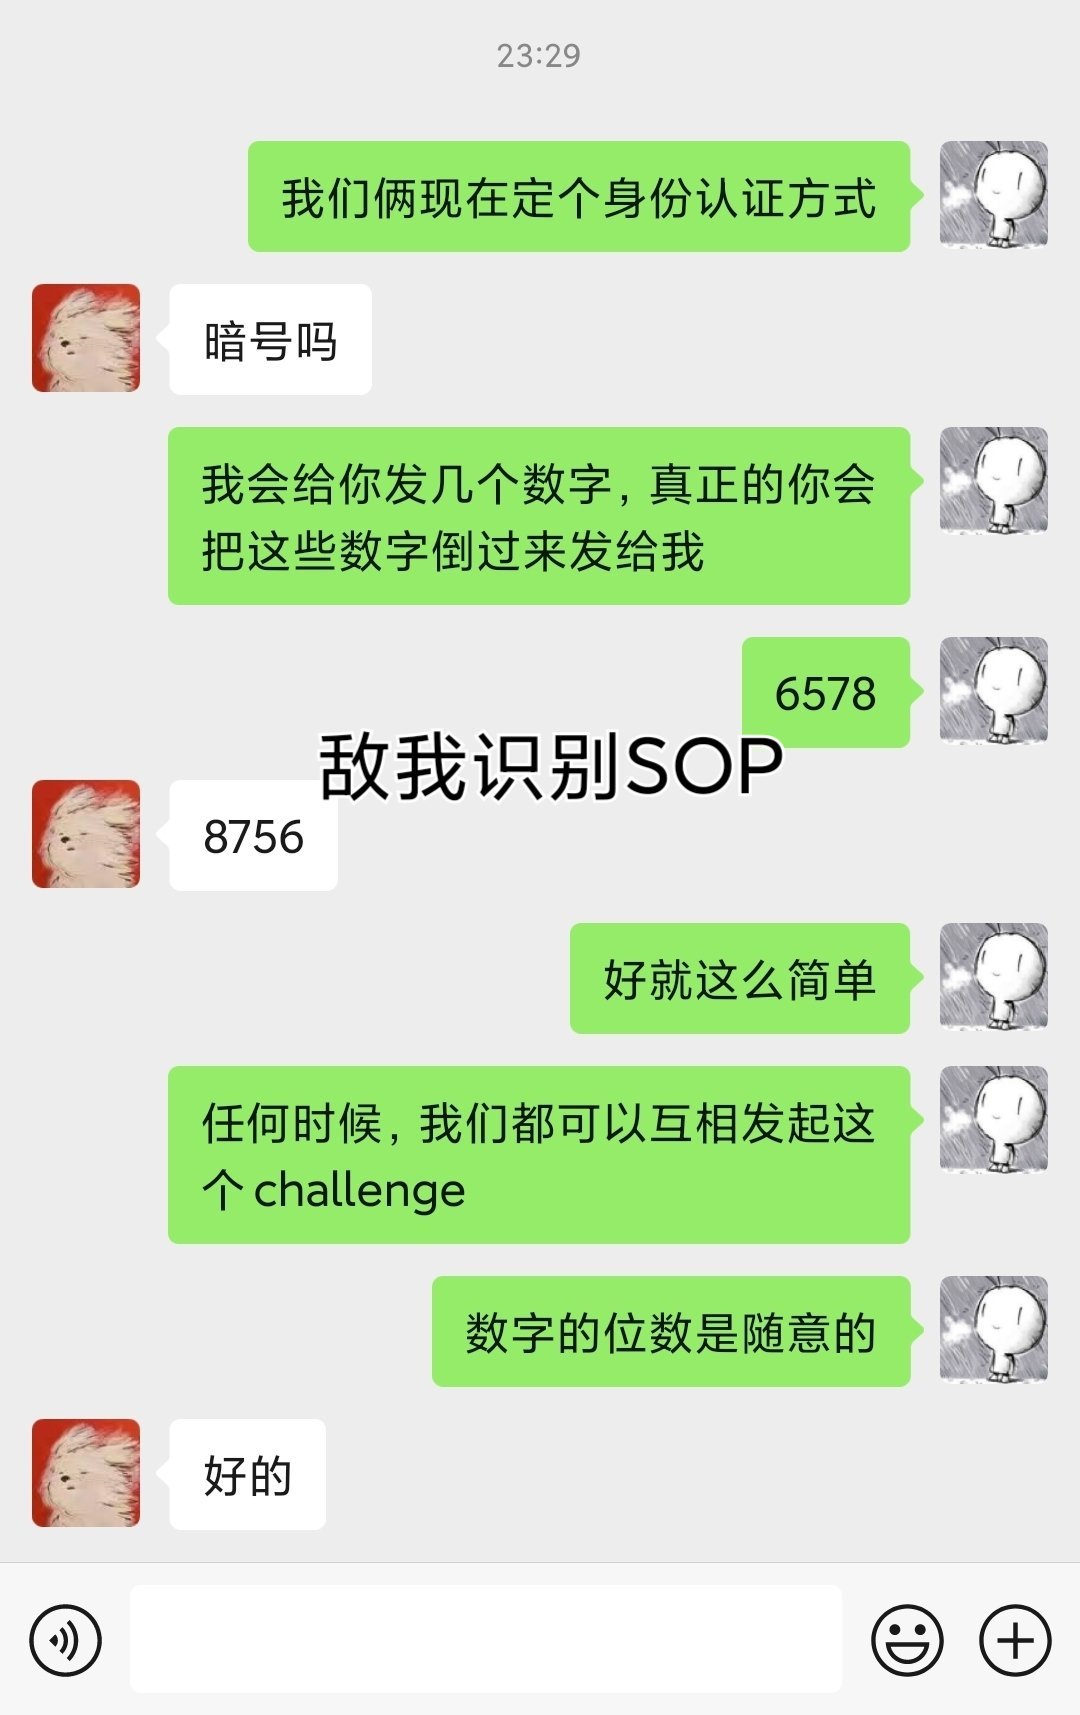
我应该先要做到: 1. 要明确转账前的身份确认流程; 2. 要定期与家庭成员对话交流,降低信息流动阻力。

配图 1配图 2配图 3配图 4配图 5配图 6

需求只会循着最低成本的方式寻求满足。

要满足“自己不被轻贱”的需求,最廉价的方式不是“努力变强”,而是“轻贱不如自己的人”。 ​​​

配图 1配图 2

食物的成本 = 标价所需劳动时间 + 排队所需时间 + 消耗热量所需时间[嘘] ​​​

“仅仅是‘善良’,常常反映的是内心对离群的焦虑和对被敌对的脆弱。这种‘善良’会招来越来越多的觊觎和撕咬,往往持续不下去——这倒不是说本人会死亡,而是说会依靠不断的消耗自身网络的资源来维持,直到维持不下去会导致性情转变——当然也有很大可能是变得成熟而可持续起来。” ​​​

配图 1配图 2配图 3配图 4

你说今天逛街试了条裙子真美,我问多少钱,你答3000,我说噢噢还行,不过我上次见到一条更美的30000呢……

整个聊完,都不需要裙子的颜色。 ​​​

#首套房贷最低首付比例调整为15%#

首付15%,相当于净杠杆率6.7倍,买100万的房,涨到115万本金就翻倍[赞]

不过,要是跌到85万甚至以下呢,银行会允许抵押物价值小于放出的贷的吗,银行会启动资产重评吗,不补保证金会被法拍强平吗?[思考] ​​​

孩子是镜子,子不教,父之过。或许这位妈妈是全职,在家说不上什么话,孩子们也就潜移默化地学到了爸爸平日里对妈妈的样子

放大配图